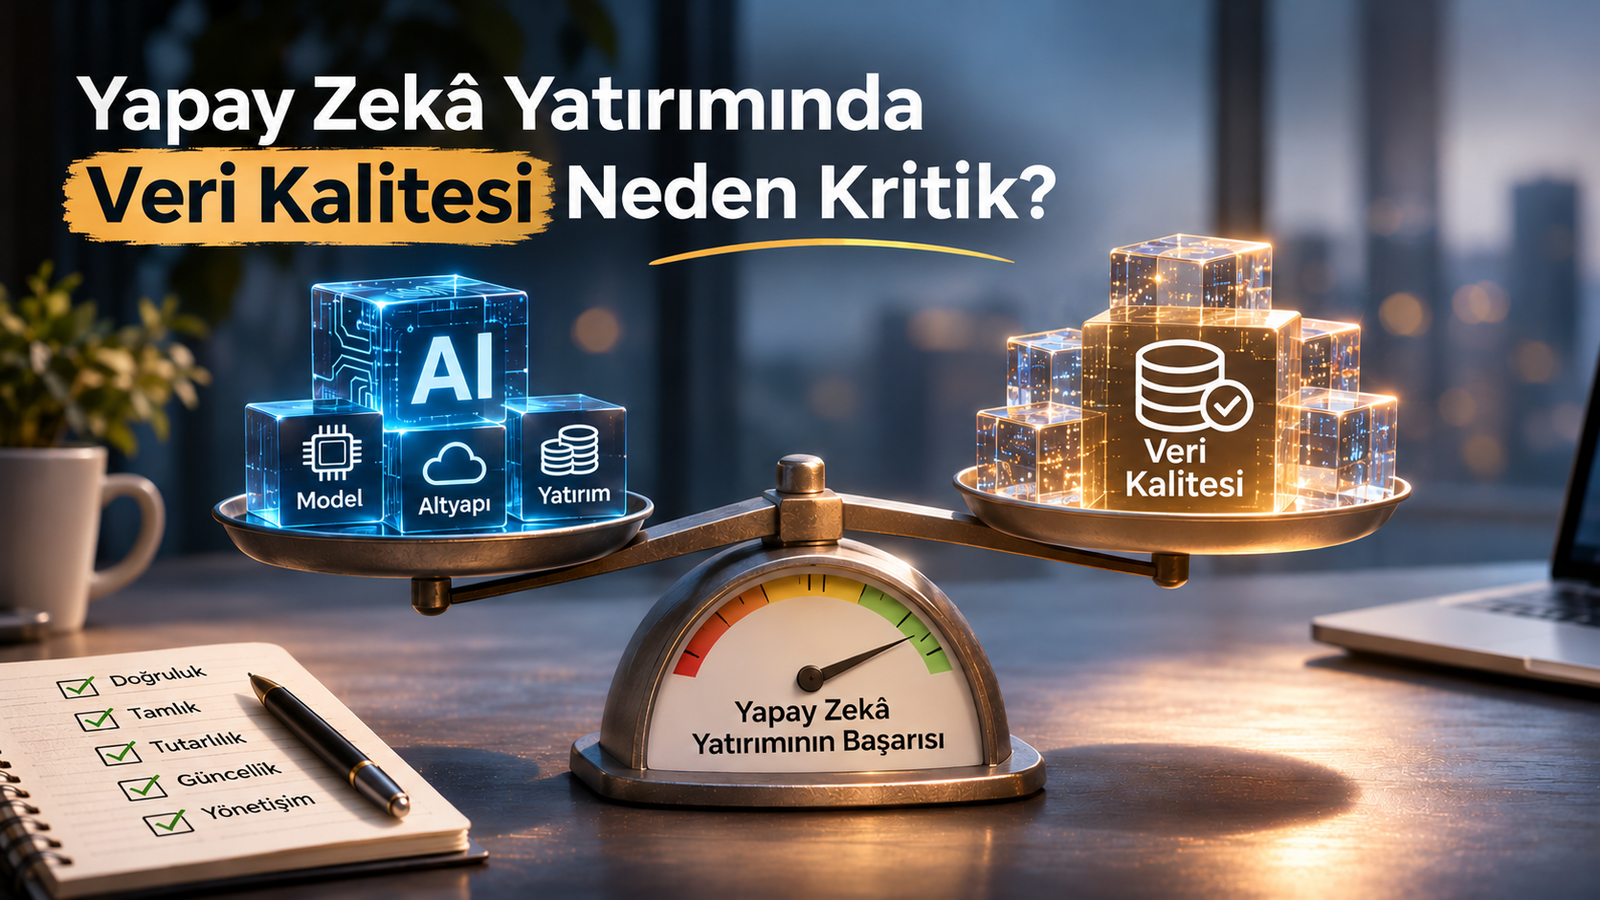
Bir şirketin gelişmiş yapay zekâ modellerine, güçlü bir teknoloji altyapısına ve önemli bir yatırım bütçesine sahip olması, yapay zekâdan beklediği iş sonuçlarını mutlaka elde edeceği anlamına gelmez. Çünkü yapay zekâ sistemlerinin başarısı yalnızca kullanılan algoritmaların yeteneklerine değil, bu sistemlerin beslendiği verilerin doğruluğuna, tutarlılığına, güncelliğine, bütünlüğüne ve kullanım amacına uygunluğuna da bağlıdır. Kurumsal dönüşüm alanındaki deneyimlerim boyunca farklı biçimlerde karşılaştığım veri sorunlarının, yapay zekâ teknolojilerinin iş süreçlerinde daha fazla kullanılmaya başlamasıyla birlikte çok daha stratejik bir önem kazandığını düşünüyorum. Bu nedenle yapay zekâ yatırımlarını değerlendirirken yalnızca teknolojinin neler yapabildiğine değil, kurumun bu teknolojiden güvenilir sonuçlar elde etmeye ne kadar hazır olduğuna da bakmamız gerektiğine inanıyorum.
Şirketler yapay zekâya yatırım yaparken neyi gözden kaçırıyor?
Bir şirketin üst yönetiminin yapay zekâyı önümüzdeki yılların en önemli yatırım alanlarından biri olarak belirlediğini düşünelim. Şirket, satış tahminlerini geliştirmek, müşteri davranışlarını daha iyi analiz etmek, üretim maliyetlerini azaltmak ve çalışanların verimliliğini artırmak amacıyla farklı teknoloji sağlayıcılarıyla görüşüyor, yapay zekâ platformlarını karşılaştırıyor, danışmanlık şirketlerinden teklifler alıyor ve pilot uygulamalar için bütçeler oluşturuyor. İlk bakışta bütün bu faaliyetler, şirketin teknolojik gelişmeleri yakından takip ettiğini ve dijital dönüşüm konusunda doğru yönde ilerlediğini gösteriyor olabilir.
Ancak projenin hazırlık çalışmalarına geçildiğinde farklı bir tabloyla karşılaşılması mümkün. Satış sistemindeki müşteri kayıtlarıyla ERP sistemindeki kayıtların tam olarak örtüşmediği, ürün kodlarının farklı sistemlerde farklı biçimlerde tanımlandığı, bazı stok hareketlerinin zamanında kaydedilmediği, finansal verilerin belirli dönemlerde manuel düzeltmeler gerektirdiği ve departmanların aynı performans göstergesini farklı hesaplama yöntemleriyle değerlendirdiği ortaya çıkabilir. Böyle bir durumda şirketin önemli miktarda veriye sahip olduğu açıktır; ancak bu verilerin ne kadarının güvenilir olduğu, hangi kararlar için kullanılabileceği ve yapay zekâ uygulamalarını ne ölçüde destekleyebileceği yeterince bilinmiyor olabilir.
Bence böyle bir organizasyonun karşısındaki temel problem, hangi yapay zekâ modelinin daha gelişmiş olduğu veya hangi teknoloji sağlayıcısının daha fazla özellik sunduğu değildir. Öncelikle kurumun sahip olduğu verilerin hangi bölümüne güvenilebileceğinin, hangi veri kaynaklarında önemli sorunlar bulunduğunun ve bu sorunların planlanan yapay zekâ uygulamalarının sonuçlarını nasıl etkileyebileceğinin anlaşılması gerekir. Çünkü yapay zekâ, kurumsal verilerdeki sorunları kendiliğinden ortadan kaldıran bir teknoloji olmadığı gibi, mevcut veri hatalarını belirlemeye, eksiklikleri tespit etmeye ve tutarsızlıkları gidermeye yardımcı olabilse de güvenilir olmayan veriler üzerinde çalışan bir sistemin her durumda güvenilir kararlar üreteceği varsayılamaz.
Üstelik yapay zekâ uygulamaları kurumsal operasyonlarla daha fazla bütünleşmeye, yalnızca analiz üretmek yerine öneriler geliştirmeye ve belirli koşullarda işlemler gerçekleştirmeye başladığında veri kalitesi sorunlarının etkileri de genişleyebilir. Geleneksel bir raporda bulunan yanlış bilginin oluşturduğu riskle, aynı yanlış bilginin otomatik bir satın alma önerisine veya üretim planlama kararına dönüşmesinin oluşturduğu risk aynı olmayabilir. Bu nedenle veri kalitesini yalnızca teknik ekiplerin çözmesi gereken bir hazırlık konusu olarak değil, yapay zekâ yatırımının ekonomik değerini, operasyonel güvenilirliğini ve sürdürülebilirliğini etkileyen stratejik bir yönetim meselesi olarak değerlendiriyorum.
Bence şirketlerin yapay zekâ yolculuğunda sorması gereken ilk sorulardan biri, yapay zekâya ne kadar hazır olduklarını yalnızca teknoloji altyapılarının gelişmişliği üzerinden mi, yoksa güvenilir veri üretme, yönetme ve kullanma kapasiteleri üzerinden de mi değerlendirdikleri olmalıdır.
Veri kalitesi neden yeni bir sorun değil?
Veri kalitesi, yapay zekâ teknolojilerinin yaygınlaşmasıyla ortaya çıkmış yeni bir kavram değil; ERP sistemlerinin kurumsal yapılarda kullanılmaya başlamasından iş zekâsı uygulamalarına, veri ambarlarından gelişmiş analitik platformlarına kadar birçok teknoloji yatırımının başarısını etkileyen temel konulardan biri. Profesyonel hayatım boyunca ERP, SAP ve kurumsal dönüşüm projelerinde farklı açılardan karşılaştığım önemli gerçeklerden biri de teknoloji projelerinin başarısının yalnızca yazılımın doğru kurulmasına, sistemlerin teknik olarak çalışmasına veya planlanan tarihte canlıya alınmasına bağlı olmamasıydı.
Örneğin bir ERP projesinde bütün teknik bileşenler sorunsuz çalışabilir, kullanıcılar sisteme erişebilir ve temel işlemler gerçekleştirilebilir; ancak müşteri ana verilerindeki hatalar satış ve tahsilat süreçlerinde sorunlara, malzeme kayıtlarındaki tutarsızlıklar üretim planlaması ve stok yönetiminde aksamalara, tedarikçi bilgilerindeki eksiklikler ise satın alma ve ödeme süreçlerinde gecikmelere neden olabilir. Bu tür durumlarda sorun her zaman yazılımın kendisinden kaynaklanmaz; çoğu zaman yazılımın kullandığı verilerin doğruluğu, bu verilerin nasıl oluşturulduğu, kim tarafından güncellendiği ve hangi kurallarla yönetildiği belirleyici hâle gelir.
Yapay zekâ çağında değişen şeyin veri kalitesinin temel önemi değil, veri sorunlarının etkileyebileceği faaliyetlerin kapsamı olduğunu düşünüyorum. Geleneksel bir raporlama sisteminde hatalı veri yanlış bir performans göstergesi oluşturabilir ve yönetici bu bilgiyi başka kaynaklarla karşılaştırarak değerlendirme fırsatı bulabilirken, yapay zekâ destekli bir uygulamada aynı veri tahminlerin, önerilerin veya otomatik işlemlerin doğrudan girdisi hâline gelebilir. Örneğin yanlış stok verileri yalnızca hatalı bir rapor oluşturmakla kalmayıp otomatik satın alma önerilerini de etkileyebilir; benzer şekilde eksik müşteri kayıtları, müşteri kaybı tahminlerinin veya satış fırsatı değerlendirmelerinin güvenilirliğini sınırlayabilir.
Ancak burada önemli bir ayrım yapılması gerektiğine inanıyorum. Her veri hatası mutlaka büyük bir iş kaybına yol açmaz ve bütün veri sorunları aynı öncelikle ele alınmamalıdır; çünkü hatanın gerçek etkisi, verinin hangi iş sürecinde kullanıldığına, hangi kararı desteklediğine, yapay zekâ sisteminin ne kadar bağımsız hareket ettiğine ve kurumun mevcut kontrol mekanizmalarına bağlıdır. Bu nedenle veri kalitesini değerlendirirken yalnızca kaç hatalı kayıt bulunduğunu ölçmekle yetinmemeli, bu hataların hangi iş kararlarını, operasyonel faaliyetleri ve ekonomik sonuçları etkileyebileceğini de anlamaya çalışmalıyız.
Veri kalitesi tam olarak ne anlama geliyor?
Kurumsal teknoloji projelerinde veri kalitesi kavramının çoğu zaman verilerin doğru olup olmadığıyla sınırlandırıldığını görüyorum. Oysa doğruluk, veri kalitesinin yalnızca bir boyutudur ve bir verinin teknik olarak doğru görünmesi, her kullanım amacı için yeterince kaliteli olduğu anlamına gelmez. ISO/IEC 25012 veri kalitesi modeli de verinin niteliğini farklı özellikler üzerinden değerlendiren bir çerçeve sunarak bu konunun yalnızca doğruluk kontrolünden ibaret olmadığını ortaya koyar.
Veri kalitesinin ilk önemli boyutu olan doğruluk, bir verinin temsil ettiği gerçek durumu ne ölçüde yansıttığıyla ilgilidir. Örneğin bir üretim şirketinin sisteminde kayıtlı stok miktarının fiziksel stokla uyumlu olması beklenirken, tamlık boyutu gerekli bilgilerin eksiksiz bulunmasını ifade eder ve müşteri kayıtlarında kritik alanların boş bırakılması belirli analizlerin yapılmasını zorlaştırabilir. Tutarlılık ise aynı verinin farklı sistemlerde veya kayıtlar arasında çelişmemesiyle ilişkilidir; ERP sistemindeki ürün koduyla üretim sistemindeki ürün kodunun aynı anlamı taşıması, bu boyutun kurumsal uygulamalardaki karşılıklarından biridir.
Bir başka önemli boyut olan güncellik, verinin kullanılacağı karar açısından yeterince yeni olmasını gerektirir. Örneğin bir önceki geceye ait stok verileri bazı stratejik analizler için yeterli olabilirken gerçek zamanlı sevkiyat kararları için yetersiz kalabilir. Geçerlilik, verinin tanımlanmış biçimlere ve iş kurallarına uygunluğunu ifade eder; teslimat tarihlerinin kabul edilen formatta bulunması veya işlem kodlarının izin verilen değerlerden oluşması buna örnek gösterilebilir. İzlenebilirlik ise özellikle yapay zekâ uygulamalarında önemli bulduğum bir başka özelliktir; çünkü bir bilginin hangi kaynaktan geldiğinin, hangi dönüşümlerden geçtiğinin ve hangi karar süreçlerinde kullanıldığının anlaşılabilmesi, üretilen sonuçların değerlendirilmesini ve gerektiğinde hataların araştırılmasını kolaylaştırır.
Bu boyutların her birinin önem derecesi, verinin kullanılacağı iş senaryosuna göre değişebilir. Müşteri hizmetlerinde kullanılan bir yapay zekâ uygulaması için güncel ürün ve hizmet bilgilerinin bulunması kritik olabilirken, finansal tahmin yapan bir modelde geçmiş verilerin tutarlılığı, dönemler arasında karşılaştırılabilir olması ve doğru sınıflandırılması daha fazla önem taşıyabilir. Üretim bakım tahmininde kullanılan bir model açısından ise sensör verilerinin zaman damgaları, eksik ölçümler ve cihazların kalibrasyon durumu belirleyici olabilir.
Dolayısıyla bütün kurumsal veriler için tek bir kalite seviyesinin veya bütün kullanım senaryolarına uygulanabilecek değişmez bir kontrol listesinin yeterli olduğunu düşünmüyorum. Benim yaklaşımımda veri kalitesi, verinin kullanılacağı iş amacından bağımsız değerlendirilemez; çünkü bir veri setinin belirli bir raporlama ihtiyacı için yeterli olması, aynı verinin otomatik karar mekanizmalarında güvenle kullanılabileceği anlamına gelmeyebilir.
Birinci risk: Yanlış verilerle doğru karar vermeye çalışmak
Yapay zekâ yatırımlarında en görünür risklerden biri, güvenilir olmayan verilerden üretilen analizlerin yönetim kararlarında kullanılmasıdır. Örneğin bir perakende şirketinin geçmiş satış verilerini, stok hareketlerini, kampanya dönemlerini ve mevsimsel değişimleri analiz ederek gelecekteki talebi tahmin etmek amacıyla yapay zekâ destekli bir uygulama geliştirdiğini düşünelim. Böyle bir uygulamanın başarılı olabilmesi için yalnızca gelişmiş bir tahmin algoritmasına sahip olması yeterli değildir; geçmiş verilerin şirketin gerçek ticari koşullarını anlamlı biçimde temsil etmesi de gerekir.
Ancak geçmiş satış kayıtlarında iade işlemlerinin tutarlı biçimde sınıflandırılmadığını, bazı mağazaların stok eksikliği nedeniyle gerçekleştiremediği satışların kaydedilmediğini ve kampanya dönemlerindeki fiyat değişikliklerinin eksik tutulduğunu varsayalım. Bu durumda yapay zekâ modelinin öğrenmeye çalıştığı geçmiş tablo, şirketin gerçek talep koşullarını tam olarak yansıtmayabilir ve model belirli ürünler için gereğinden fazla veya az stok önerileri oluşturabilir.
Burada önemli olan, veri sorunları bulunan her yapay zekâ modelinin mutlaka yanlış sonuç üreteceğini iddia etmek değil, bu sorunların tahminlerin güvenilirliğini sınırlayabilecek bir belirsizlik oluşturduğunu kabul etmektir. Benzer durumlar finans, üretim, insan kaynakları ve müşteri yönetimi süreçlerinde de ortaya çıkabilir; çünkü finansal tahmin modellerinin farklı muhasebe dönemlerini karşılaştırılabilir biçimde ele alması, müşteri kaybı tahmin modellerinin müşterilerin gerçek davranışlarını yansıtan verilere dayanması ve proje gecikme tahmin modellerinin geçmiş proje takvimleriyle gerçekleşen süreler ve gecikme nedenleri arasında anlamlı ilişkiler kurabilmesi gerekir.
Bu nedenle yapay zekâ projelerinde model geliştirme çalışmalarına başlamadan önce verilerin kullanım amacına uygunluğunu değerlendirmeyi, veri kaynaklarındaki önemli eksiklikleri belirlemeyi ve bu eksikliklerin iş sonuçları üzerindeki olası etkilerini anlamayı gerekli görüyorum. Çünkü yanlış verilerle geliştirilen bir modelin teknik açıdan başarılı görünmesi, iş açısından doğru kararlar ürettiğini tek başına kanıtlamaz.
İkinci risk: Yapay zekânın mevcut kurumsal sorunları büyütmesi
Veri kalitesiyle ilgili daha az görünür ancak önemli bulduğum başka bir risk, yapay zekâ uygulamalarının mevcut kurumsal süreçlerdeki tutarsızlıkları ortadan kaldırmak yerine daha geniş bir alana taşıyabilmesidir. Örneğin satış, üretim, depo ve satın alma departmanlarının farklı sistemler kullandığı bir üretim şirketinde, her uygulama kendi görevini başarıyla yerine getiriyor olsa bile veri tanımları, güncelleme kuralları ve süreçler arasındaki bilgi akışları bakımından önemli farklılıklar bulunabilir.
Şirketin bu sistemlerin üzerine yapay zekâ destekli bir operasyon yönetimi çözümü eklemeye karar verdiğini ve yeni uygulamanın satış taleplerini analiz ederek üretim kapasitesini değerlendirdiğini, stok durumunu kontrol ettiğini ve satın alma önerileri hazırladığını düşünelim. Temel veriler arasındaki tutarsızlıklar giderilmemişse yapay zekâ uygulaması da bu sorunlardan etkilenebilir; örneğin aynı malzemenin iki sistemde farklı ölçü birimleriyle tanımlanması miktar hesaplamalarında hatalara, müşteri önceliklerinin farklı sistemlerde farklı kurallarla belirlenmesi ise teslimat önerilerinde tutarsızlıklara neden olabilir.
Bu durum bana kurumsal dönüşüm çalışmalarında sık karşılaşılan önemli bir gerçeği hatırlatıyor: Mevcut teknoloji mimarisinin üzerine yeni bir uygulama eklemek, alttaki süreçlerin ve verilerin doğru yönetildiğini garanti etmez. Hatta veri akışları yeterince anlaşılmadan kurulan yeni entegrasyonlar, mevcut sorunların kaynağını belirlemeyi daha da zorlaştırabilir ve farklı departmanların aynı veriye ilişkin farklı değerlendirmeler yapmasına neden olabilir.
Bu nedenle yapay zekâ yatırımlarının kurumun mevcut veri mimarisinden, süreçlerinden ve yönetişim yapısından bağımsız değerlendirilmemesi gerektiğini düşünüyorum. Benim için önemli olan, yeni bir yapay zekâ uygulamasının teknik olarak mevcut sistemlerle bağlantı kurabilmesi kadar, bu sistemler arasında taşınan bilgilerin ortak bir iş anlamına sahip olması ve gerektiğinde doğrulanabilir biçimde yönetilebilmesidir.
Üçüncü risk: Veri kalitesinin görünmeyen ekonomik maliyeti
Veri kalitesinin ekonomik etkilerinin her zaman doğrudan teknoloji bütçelerinde görülmediğini düşünüyorum; çünkü maliyetin önemli bir bölümü çalışanların günlük faaliyetleri içerisinde, aynı bilgileri tekrar kontrol etmeleri, hatalı kayıtları düzeltmeleri, farklı raporları karşılaştırmaları veya sistemler arasındaki uyuşmazlıkları gidermek için ek çalışmalar yapmaları sonucunda ortaya çıkabilir. Bu faaliyetler çoğu zaman ayrı bir maliyet kalemi olarak izlenmediği için şirketler veri sorunlarının ne kadar kapasite tükettiğini yeterince açık biçimde göremeyebilir.
Bunu varsayımsal bir hesaplamayla açıklamak istiyorum. Bir şirketin yapay zekâ destekli satış tahmini uygulaması geliştirdiğini ve projede görev alan 12 çalışanın veri tutarsızlıklarını belirlemek ve düzeltmek için haftada ortalama dört saat harcadığını varsayalım. Bu durumda haftalık toplam 48 saatlik bir iş yükü oluşur ve yılda 48 çalışma haftası üzerinden hesaplandığında veri düzeltme faaliyetleri için yaklaşık 2.304 saatlik kapasite tüketimi ortaya çıkar. Saat başına toplam iş gücü maliyetinin varsayımsal olarak 1.000 TL olduğunu kabul edersek bu süre, yıllık 2.304.000 TL'lik brüt kapasite maliyetine karşılık gelir.
Burada kullanılan rakamların gerçek bir şirketin ölçülmüş performansını temsil etmediğini özellikle belirtmek istiyorum. Bu hesaplama yalnızca veri düzeltme çalışmalarının ekonomik büyüklüğünü anlamak amacıyla hazırlanmış açıklayıcı bir senaryodur ve söz konusu tutarın tamamını doğrudan finansal tasarruf olarak değerlendirmek doğru olmaz. Çünkü çalışanların veri düzeltmeye ayırdığı sürenin azaltılması, şirketin aynı miktarda nakit tasarrufu sağladığı anlamına gelmez; gerçek ekonomik fayda, kazanılan kapasitenin nasıl değerlendirildiğine, başka faaliyetlerde kullanılıp kullanılmadığına ve iş sonuçlarına ne ölçüde katkı sağladığına bağlıdır.
Buna rağmen bu örneğin önemli bir yönetim sorusuna işaret ettiğini düşünüyorum. Şirketler yapay zekâ yatırımlarının geri dönüşünü hesaplarken yazılım lisanslarını, danışmanlık giderlerini, altyapı maliyetlerini ve model geliştirme çalışmalarını değerlendirdikleri kadar veri hazırlama, temizleme, doğrulama ve sürekli kalite kontrol maliyetlerini de dikkate alıyorlar mı?
Bence yapay zekâ projelerinin toplam sahip olma maliyetinde bu çalışmaların açık biçimde değerlendirilmesi gerekir. Çünkü modelin ilk kez geliştirilmesi kadar, canlı ortamda güvenilir verilerle çalışmaya devam etmesi de önemlidir ve veri kalitesinin sürekli yönetilmesi için gereken iş gücü, teknoloji ve yönetişim faaliyetleri yatırımın ekonomik değerlendirmesinin bir parçası olmalıdır.
Dördüncü risk: Güven kaybı ve yapay zekânın benimsenmemesi
Yapay zekâ projelerinin başarısını yalnızca teknik performans üzerinden değerlendirmiyorum; çünkü bir uygulamanın iş süreçlerine gerçek katkı sağlayabilmesi için çalışanların ve yöneticilerin sistemin ürettiği sonuçlara ne kadar güvenebildiği de önemli. Örneğin bir yönetici, yapay zekâ destekli raporlama sisteminden aldığı bilgilerin sık sık yanlış olduğunu fark ederse zamanla bu raporları kullanmaktan kaçınabilir veya her sonucu başka kaynaklarla doğrulama ihtiyacı duyabilir. Benzer şekilde bir satış yöneticisi, müşteri fırsatlarına ilişkin önerilerin güncel olmayan bilgilerden üretildiğini düşünüyorsa sistemin tavsiyelerini dikkate almayabilir.
Böyle bir durumda şirket teknik olarak çalışan, hatta belirli performans testlerinden başarıyla geçmiş bir yapay zekâ uygulamasına sahip olabilir; ancak uygulamanın günlük iş süreçlerinde benimsenmesi ve beklenen ekonomik faydayı oluşturması sınırlı kalabilir. Bu nedenle yapay zekâ yatırımlarında güvenin iki yönlü değerlendirilmesi gerektiğini düşünüyorum: Sistemin gerçek kullanım koşullarında güvenilir sonuçlar üretmesi ve kullanıcıların bu sonuçların hangi verilere dayandığını, hangi sınırlara sahip olduğunu ve hangi durumlarda ek doğrulama gerektirdiğini anlayabilmesi.
Yalnızca model doğruluğunun ölçülmesi bu açıdan yeterli olmayabilir. Veri kaynaklarının izlenebilirliği, hataların nasıl düzeltildiği, sistemin hangi koşullarda belirsizlik taşıdığı ve sonuçların ne zaman insan kontrolünden geçirilmesi gerektiği de açıklanmalıdır. Çünkü kurumsal yapay zekâ uygulamalarında güvenin yalnızca teknoloji sağlayıcısının itibarıyla veya ürünün gelişmiş özellikleriyle oluşturulabileceğini düşünmüyorum; güvenin, uygulamanın gerçek kullanım koşullarındaki performansı, şeffaflığı ve denetlenebilirliğiyle desteklenmesi gerekir.
Beşinci risk: Yapay zekâ ajanlarıyla hataların operasyonel işlemlere dönüşmesi
Yapay zekâ teknolojilerinin gelişimiyle birlikte veri kalitesinin daha da önemli hâle gelebileceği alanlardan biri, farklı sistemlerle etkileşim kurabilen ve belirli görevleri yerine getirebilen yapay zekâ ajanlarıdır. Geleneksel bir yapay zekâ uygulaması belirli bir soruya cevap verebilir veya analiz hazırlayabilirken, yapay zekâ ajanları kendilerine tanımlanan hedefler doğrultusunda farklı sistemlerden bilgi toplayabilir, belirli işlemleri başlatabilir ve birden fazla adımı içeren iş akışlarında görev alabilir.
Bu gelişmenin kurumlara önemli fırsatlar sunabileceğini düşünüyorum; ancak aynı zamanda veri kalitesi sorunlarının etkileri açısından yeni değerlendirmeler yapılmasını da gerekli görüyorum. Örneğin bir satın alma ajanının stok seviyelerini takip ettiğini, tedarikçi tekliflerini karşılaştırdığını ve belirli koşullarda sipariş taslağı oluşturduğunu düşünelim. Stok verileri güncel değilse ajan yanlış miktarlarda sipariş önerebilir, tedarikçi ana verileri hatalıysa yanlış ticari koşulları değerlendirebilir ve ürünlerin ölçü birimleri farklı sistemlerde tutarsız biçimde tanımlanmışsa hesaplamalarda önemli farklılıklar oluşabilir.
Bu risklerin yönetilmesi için yalnızca veri kalitesini artırmanın yeterli olmayabileceğine inanıyorum. Ajanın hangi verilere erişebileceğinin, hangi işlemleri gerçekleştirebileceğinin, hangi durumlarda durdurulacağının ve hangi kararlar için insan onayı gerekeceğinin açık biçimde belirlenmesi gerekir. Özellikle finansal sonuç doğuran, müşteri ilişkilerini etkileyen veya kritik operasyonel süreçlerde değişiklik oluşturan işlemler için yetki sınırlarının ve kontrol mekanizmalarının önceden tanımlanmasını önemli buluyorum.
Benim yaklaşımımda yapay zekâ ajanlarının kullanımında veri kalitesiyle yönetişim birbirinden ayrı düşünülemez; çünkü yanlış veriye dayanarak hazırlanan bir öneriyle, yanlış veriye dayanarak gerçekleştirilen bir işlem arasında önemli bir fark bulunur. Birincisinde insanın değerlendirme ve düzeltme fırsatı daha geniş olabilirken, ikincisinde hatanın operasyonel süreçlere yansıması daha hızlı gerçekleşebilir. Bu nedenle yapay zekâ ajanlarının kurumsal kullanımında veri güvenilirliği, erişim yetkileri, işlem sınırları ve insan gözetimi birlikte ele alınmalıdır.
Veri kalitesi yalnızca CIO'nun sorumluluğu olabilir mi?
Kurumsal yapay zekâ yatırımlarında yeniden değerlendirilmesi gerektiğini düşündüğüm konulardan biri de veri kalitesinin organizasyonel sahipliğidir. Veri kalitesi çoğu zaman BT departmanının çözmesi gereken teknik bir problem olarak görülse de kurumsal verilerin önemli bir bölümü doğrudan iş süreçleri içerisinde oluşturulur, güncellenir ve kullanılır. Müşteri bilgileri satış ve müşteri hizmetleri faaliyetlerinde, tedarikçi kayıtları satın alma süreçlerinde, malzeme ve stok verileri üretim, depo ve lojistik operasyonlarında, finansal bilgiler ise muhasebe ve finans yönetimi faaliyetlerinde ortaya çıkar.
Dolayısıyla bir verinin iş açısından ne anlama geldiğini, hangi koşullarda doğru kabul edileceğini ve hangi durumlarda düzeltilmesi gerektiğini yalnızca teknik ekiplerin belirlemesi her zaman mümkün değildir. Örneğin aynı müşterinin iki farklı şirket olarak kaydedilip kaydedilmediğini anlamak için ticari ilişkilerin ve müşteri yönetimi kurallarının bilinmesi gerekebilir; benzer şekilde bir ürünün aktif veya pasif kabul edilmesi, teknik bir veri tabanı kararından çok iş süreçleri ve ticari gereksinimlerle ilgili olabilir.
Bu nedenle veri sahipliğinin açık biçimde tanımlanmasını önemli buluyorum. İş birimleri kritik verilerin iş anlamından, oluşturulmasından ve doğruluğundan sorumlu olurken, BT ekipleri veri mimarisini, entegrasyonları, teknik kontrolleri ve güvenli erişimi desteklemelidir. Veri yönetişiminden sorumlu yapılar ortak standartların oluşturulmasını, kalite ölçümlerinin gerçekleştirilmesini ve sorumlulukların koordinasyonunu sağlamalı; CEO ve üst yönetim ise veri kalitesinin stratejik önceliklerle ilişkisini ve gerekli kaynakların tahsisini değerlendirmelidir.
Bence kurumsal veri yönetişiminde karşılaşılabilecek en önemli sorunlardan biri, veri kalitesinin herkesin sorumluluğu olarak tanımlanmasına rağmen sonuçlarından kimin hesap vereceğinin belirsiz kalmasıdır. Bu nedenle sorumlulukların yalnızca organizasyon şemalarında veya proje dokümanlarında belirtilmesi yeterli değildir; veri hatalarının nasıl tespit edileceği, kim tarafından düzeltileceği ve iyileştirme sonuçlarının nasıl izleneceği de açık biçimde belirlenmelidir.
CEO, CIO ve COO aynı veri sorununa neden farklı bakıyor?
Bir yapay zekâ yatırımının başarısı açısından CEO, CIO ve COO rollerinin birlikte değerlendirilmesi gerektiğini düşünüyorum; çünkü aynı veri sorunu bu yöneticilerin sorumluluk alanlarında farklı sonuçlar doğurabilir. Örneğin bir şirketin üretim planlamasında kullanılacak yapay zekâ uygulaması geliştirdiğini düşünelim. COO açısından temel mesele üretim kapasitesinin doğru planlanması, teslimat performansının iyileştirilmesi ve operasyonel kayıpların azaltılması olabilirken, CIO açısından veri kaynaklarının güvenilirliği, sistem entegrasyonları, erişim yetkileri ve teknik mimarinin sürdürülebilirliği ön plana çıkabilir. CEO ise yatırımın şirketin rekabet gücüne, kârlılığına ve stratejik hedeflerine ne kadar katkı sağlayacağını değerlendirmek isteyebilir.
Bu bakış açılarının her biri gerekli olmakla birlikte birbirinden kopuk yönetildiklerinde önemli sorunlar ortaya çıkabilir. Örneğin BT departmanı teknik entegrasyonları tamamlamış ve uygulamayı çalışır hâle getirmiş olabilir; ancak iş birimleri veri tanımlarında uzlaşamamışsa operasyonel sonuçlar beklenen düzeyde gerçekleşmeyebilir. Benzer şekilde operasyon ekipleri veri kalitesini geliştirmek için önemli çalışmalar yapabilir; ancak bu faaliyetler şirketin stratejik yatırım öncelikleriyle ilişkilendirilmezse gerekli kaynakların ayrılması zorlaşabilir.
Bu nedenle yapay zekâ yatırımlarında veri kalitesini yalnızca proje başlangıcında tamamlanması gereken teknik bir faaliyet olarak değil, üst yönetim düzeyinde sahiplenilmesi gereken kurumsal bir yetkinlik olarak değerlendiriyorum. COO'nun operasyonel ihtiyaçları, CIO'nun teknoloji ve veri mimarisi sorumlulukları ve CEO'nun stratejik öncelikleri ortak bir yönetim yaklaşımında buluşmadığında veri kalitesi çalışmalarının sürdürülebilir sonuçlar üretmesi zorlaşabilir.
Yapay zekâya hazır olmak için bütün veriler kusursuz mu olmalı?
Veri kalitesinin kritik olduğunu vurgularken özellikle açıklamak istediğim bir yanlış anlama bulunuyor. Bir şirketin yapay zekâ yatırımı yapmadan önce bütün kurumsal verilerini kusursuz hâle getirmesi gerektiğini düşünmüyorum; çünkü böyle bir hedef, özellikle yıllar içerisinde farklı sistemler, iş uygulamaları ve kayıt standartları geliştirmiş büyük organizasyonlar açısından gerçekçi olmayabilir.
Bütün kurumsal verileri aynı anda temizlemek, standartlaştırmak ve yeniden yapılandırmak önemli miktarda zaman, bütçe ve insan kaynağı gerektirebilir. Üstelik her verinin bütün kullanım alanlarında aynı kalite seviyesine sahip olması da gerekli değildir; çünkü müşteri hizmetleri için geliştirilen bir bilgi asistanının ihtiyaç duyduğu verilerle üretim arızalarını tahmin eden bir modelin ihtiyaç duyduğu veriler birbirinden farklıdır.
Bu nedenle veri kalitesi çalışmalarını somut kullanım senaryolarına bağlamanın daha doğru olduğunu düşünüyorum. Öncelikle hangi iş probleminin çözülmek istendiği belirlenmeli, ardından bu problemi çözmek için hangi verilerin kritik olduğu ortaya konulmalı, mevcut veri kalitesi ölçülmeli ve kullanım senaryosunun gerektirdiği kabul edilebilir eşikler tanımlanmalıdır. Böylece veri iyileştirme çalışmaları doğrudan iş değeriyle ilişkilendirilebilir ve kurumun kaynakları en önemli sorunların çözümüne yönlendirilebilir.
Bence burada amaç bütün kurumsal verileri kusursuz hâle getirmek değil, kritik kararlar için gerekli verilerin yeterince güvenilir olmasını sağlamaktır. Ancak bu yaklaşımın veri sorunlarını görmezden gelmek veya kalite kontrollerini azaltmak anlamına gelmediğini de belirtmek gerekir; aksine verinin kullanım amacı, olası hata etkisi ve iş riski dikkate alınarak daha bilinçli bir önceliklendirme yapılmasını gerektirir.
Kurumsal yapay zekâ hazırlığında veri kalitesini nasıl değerlendirebiliriz?
Veri kalitesinin önemini açıklamak tek başına yeterli değil; kurumların bu konuyu ölçülebilir biçimde değerlendirebilmesi, mevcut durumunu anlayabilmesi ve iyileştirme çalışmalarını önceliklendirebilmesi gerekiyor. Bu amaçla yedi boyutlu bir değerlendirme yaklaşımının yararlı olabileceğini düşünüyorum. Burada önerdiğim yaklaşım, belirli bir uluslararası standardın birebir olgunluk modeli değildir; ISO/IEC 25012, DAMA-DMBOK ve NIST AI RMF gibi çerçevelerde ele alınan ilkelerden yararlanılarak oluşturulabilecek uygulama odaklı bir değerlendirme önerisidir.
1. Kritik veri varlıklarının belirlenmesi
İlk aşamada yapay zekâ kullanım senaryosunun hangi verilere ihtiyaç duyduğu, bu verilerin hangi sistemlerde tutulduğu, hangi departmanlar tarafından oluşturulduğu ve hangi iş kararlarını etkilediği anlaşılmalıdır. Örneğin satış tahmini için geçmiş satışlar, fiyat değişiklikleri, kampanyalar ve stok bulunurluğu önemli olabilir; ancak bütün kullanım senaryolarının aynı veri setlerine ihtiyaç duyacağı varsayılmamalıdır. Bu nedenle veri varlıklarının belirlenmesi, yalnızca teknik bir envanter oluşturma çalışması olarak değil, verilerle iş hedefleri arasındaki ilişkinin ortaya konulması olarak değerlendirilmelidir.
2. Veri doğruluğu ve tamlığı
İkinci aşamada kritik verilerin gerçek iş durumunu ne kadar doğru yansıttığı ve gerekli bilgilerin ne ölçüde eksiksiz bulunduğu ölçülmelidir. Eksik kayıt oranları, hatalı değerler ve iş kurallarına aykırı bilgiler belirlenirken kontroller yalnızca teknik alanların dolu olup olmadığını değil, verilerin iş açısından anlamlı ve kullanılabilir olup olmadığını da değerlendirmelidir. Örneğin bir müşteri kaydındaki zorunlu alanların tamamının doldurulmuş olması, kayıtlı bilgilerin mutlaka doğru veya güncel olduğu anlamına gelmeyebilir.
3. Veri tutarlılığı ve bütünlüğü
Üçüncü aşamada farklı sistemlerde bulunan ortak veriler karşılaştırılmalı ve müşteri, ürün, tedarikçi ve organizasyon gibi ana verilerde tutarsızlıklar olup olmadığı incelenmelidir. Veriler arasındaki ilişkilerin korunması, farklı kaynaklardan gelen bilgilerin ortak anlam taşıması ve kritik kayıtların birbirleriyle uyumlu biçimde kullanılabilmesi, özellikle birden fazla sistemden veri toplayan yapay zekâ uygulamalarında önemli olabilir. Bu nedenle veri bütünlüğünün yalnızca teknik bağlantılar üzerinden değil, ortak iş tanımları ve veri yönetimi kuralları üzerinden de değerlendirilmesi gerekir.
4. Veri güncelliği
Dördüncü aşamada verilerin hangi sıklıkla güncellendiği ve bu güncelleme sıklığının kullanım senaryosunun gerektirdiği zaman aralığıyla uyumlu olup olmadığı değerlendirilmelidir. Bazı yapay zekâ uygulamaları günlük güncellemelerle yeterli performans gösterebilirken, bazı uygulamalar çok daha kısa sürelerde güncellenen verilere ihtiyaç duyabilir. Bu nedenle güncellik gereksiniminin bütün sistemler için aynı şekilde belirlenmesi yerine, desteklenen iş kararının zaman hassasiyeti ve olası hata etkisi dikkate alınmalıdır.
5. Veri sahipliği ve yönetişim
Beşinci aşamada kritik veri alanlarının sahipleri açık biçimde tanımlanmalı; veri hatalarının kim tarafından düzeltileceği, kalite kurallarını kimin onaylayacağı ve istisnaların nasıl yönetileceği belirlenmelidir. Bu sorumlulukların yalnızca proje döneminde geçerli olması yeterli değildir; çünkü veri kaynakları ve iş süreçleri değiştikçe yeni kalite sorunları ortaya çıkabilir. Bu nedenle veri sahipliği ve yönetişim mekanizmalarının yapay zekâ uygulaması canlıya alındıktan sonra da devam etmesi gerekir.
6. Veri güvenliği ve erişim kontrolü
Altıncı aşamada yapay zekâ uygulamalarının hangi verilere erişebileceği, bu verilerin hangi amaçlarla kullanılabileceği ve erişimlerin nasıl denetleneceği değerlendirilmelidir. Kişisel veriler, ticari sırlar ve diğer hassas bilgiler için uygun koruma mekanizmaları oluşturulmalı; verilerin yüksek kalitede olması, her amaçla kullanılabilecekleri şeklinde yorumlanmamalıdır. Bu nedenle veri kalitesiyle veri güvenliği ve hukuka uygun kullanımın ayrı ancak birlikte yönetilmesi gereken konular olduğunu düşünüyorum.
7. Sürekli izleme ve iyileştirme
Yedinci aşamada veri kalitesi kontrolleri yalnızca proje başlangıcında gerçekleştirilen bir faaliyet olmaktan çıkarılmalı ve sürekli izleme mekanizmalarıyla desteklenmelidir. İş süreçleri değiştikçe, yeni sistemler devreye girdikçe ve veri kaynakları güncellendikçe kalite sorunları yeniden ortaya çıkabileceğinden, kritik göstergelerin düzenli izlenmesi, sorunların kayıt altına alınması ve düzeltici faaliyetlerin takip edilmesi gerekir.
Bence kurumsal yapay zekâ hazırlığında veri kalitesi değerlendirmesinin amacı yalnızca bir puan veya olgunluk seviyesi üretmek olmamalıdır. Asıl amaç, yatırımın başarısını etkileyebilecek veri risklerini görünür hâle getirmek, bu risklerin iş sonuçlarıyla ilişkisini anlamak ve iyileştirme çalışmalarını yönetilebilir bir programa dönüştürmektir.
Veri kalitesinin iş sonuçlarına etkisini nasıl ölçebiliriz?
Veri kalitesinin değerlendirilmesinde bütün şirketler için geçerli tek bir gösterge bulunmadığını düşünüyorum; çünkü kritik veri kaynakları, iş süreçleri, kullanım senaryoları ve kabul edilebilir risk seviyeleri sektörden sektöre, hatta aynı şirketin farklı departmanları arasında değişebilir. Buna rağmen doğruluk, tamlık, tutarlılık, güncellik, ana veri yönetimi, yönetişim, izlenebilirlik, operasyonel etki ve yapay zekâ performansı gibi alanlarda kullanılabilecek ölçütler belirlenebilir.
| Değerlendirme alanı | Örnek gösterge | Olası iş etkisi |
|---|---|---|
| Doğruluk | Doğrulama testlerini geçen kayıt oranı | Yanlış analiz ve karar riskinin azalması |
| Tamlık | Kritik alanlarda eksik veri oranı | Analiz kapsamının iyileşmesi |
| Tutarlılık | Sistemler arası çelişkili kayıt oranı | Manuel uzlaştırma ihtiyacının azalması |
| Güncellik | Belirlenen süre içinde güncellenen kayıt oranı | Daha zamanında karar desteği |
| Ana veri yönetimi | Mükerrer müşteri veya ürün kayıt oranı | Daha güvenilir kurumsal görünüm |
| Veri yönetişimi | Sahibi atanmış kritik veri alanlarının oranı | Daha açık hesap verebilirlik |
| İzlenebilirlik | Kaynağı doğrulanabilen kritik veri oranı | Denetlenebilirlik ve güven |
| Operasyonel etki | Veri kaynaklı yeniden işleme süresi | Kapasite ve verimlilik kazanımı |
| Yapay zekâ performansı | Veri kalitesi sorunlarına bağlı önemli çıktı hataları | Daha güvenilir uygulama sonuçları |
Bu göstergelerin tamamının her kurumda kullanılması gerekli olmayabilir; önemli olan, seçilen yapay zekâ kullanım senaryosunun başarısını etkileyen kritik veri risklerini belirlemek ve ölçümü bu alanlardan başlatmaktır. Örneğin müşteri kaybı tahmininde müşteri kimliklerinin tutarlılığı önemli olabilirken, üretim bakım tahmininde sensör verilerinin eksiksizliği ve zaman doğruluğu daha kritik olabilir.
Ayrıca veri kalitesi göstergeleriyle iş sonuçları arasındaki ilişkinin ölçülmesini de önemli buluyorum. Mükerrer müşteri kayıtlarının azalması tek başına başarılı bir yapay zekâ yatırımı anlamına gelmez; bu iyileştirmenin müşteri analizlerinin güvenilirliğine, çalışanların iş yüküne veya karar süreçlerine nasıl yansıdığı da değerlendirilmelidir. Böylece veri kalitesi çalışmaları yalnızca teknik göstergeler üzerinden değil, kurumun elde etmek istediği iş sonuçları üzerinden de yönetilebilir.
Örnek bir yapay zekâ yatırımında veri kalitesi nasıl ölçülebilir?
Konuyu somutlaştırmak amacıyla bir üretim şirketinin yapay zekâ destekli talep tahmini uygulaması geliştirmek istediğini varsayalım. Şirketin temel hedefi stok fazlasını azaltmak, ürün bulunurluğunu geliştirmek ve talep değişikliklerine daha etkili yanıt verebilmektir. Bu amaçla geçmiş satış kayıtları, stok hareketleri, ürün ana verileri, kampanya bilgileri ve tedarik süreleri gibi kritik veri kaynakları belirlenerek mevcut durum değerlendirmesi yapılır.
Varsayımsal bir ön değerlendirmede kritik ürün kayıtlarının tamlık oranının %88, mükerrer ürün kayıt oranının %6, güncellik şartını karşılayan stok kayıtlarının oranının %82 ve kritik veri alanlarında sahiplik oranının %55 olduğu, ayrıca veri kaynaklı manuel düzeltme faaliyetlerinin ayda 120 saatlik iş yükü oluşturduğu tespit edilmiş olsun. Şirket, pilot çalışma kapsamında bu göstergeler için belirli iyileştirme hedefleri oluşturabilir.
| Gösterge | Başlangıç | Pilot hedefi |
|---|---|---|
| Kritik ürün kayıtlarında tamlık | %88 | %98 |
| Mükerrer ürün kayıt oranı | %6 | %1 |
| Güncellik şartını karşılayan stok kayıtları | %82 | %97 |
| Kritik veri alanlarında sahiplik oranı | %55 | %100 |
| Veri kaynaklı manuel düzeltme süresi | 120 saat/ay | 40 saat/ay |
Burada kullanılan rakamlar gerçek bir şirketten alınmış araştırma sonuçları değildir; yalnızca örnek bir ölçüm yaklaşımını açıklamak amacıyla oluşturulmuş varsayımsal değerlerdir. Ayrıca tabloda yer alan hedeflerin evrensel veri kalitesi standartları olarak değerlendirilmemesi gerekir; çünkü gerçek bir projede kabul edilebilir kalite seviyeleri, iş riski, kullanım senaryosunun gereksinimleri ve kurumun mevcut koşulları üzerinden belirlenmelidir.
Bu çalışmada yalnızca veri kalitesi iyileştirmelerinin ölçülmesi yeterli olmaz. Talep tahmin hatası, stokta bulunmama oranı, fazla stok maliyeti ve kullanıcıların yapay zekâ önerilerini kabul etme oranı gibi iş göstergelerinin de izlenmesi gerekir. Böylece veri kalitesinde gerçekleştirilen iyileştirmelerin yapay zekâ uygulamasının performansına ve şirketin operasyonel sonuçlarına ne ölçüde katkı sağladığı değerlendirilebilir.
Ancak burada nedensellik konusunda dikkatli olunması gerektiğini düşünüyorum. Tahmin performansındaki bir iyileşme yalnızca veri temizliğinden kaynaklanmayabilir; model değişiklikleri, piyasa koşulları veya operasyonel uygulamalar da sonucu etkileyebilir. Bu nedenle mümkün olduğunda karşılaştırmalı pilotlar ve uygun ölçüm tasarımları kullanılarak veri kalitesi iyileştirmelerinin etkisinin diğer değişkenlerden ayrıştırılmaya çalışılması yararlı olabilir.
Veri kalitesi için bütün şirketi kapsayan büyük bir program mı başlatmalıyız?
Kurumların yapay zekâ hazırlığında karşılaşabileceği yönetim hatalarından birinin, veri kalitesi sorunlarının büyüklüğünü gördükten sonra bütün organizasyonu aynı anda dönüştürmeye çalışmak olduğunu düşünüyorum. Elbette bazı şirketlerde geniş kapsamlı bir kurumsal veri dönüşümü programı gerekli olabilir; ancak her yapay zekâ yatırımı için bütün veri kaynaklarının yeniden yapılandırılmasını hedefleyen büyük bir program başlatmak, özellikle zaman ve kaynak kısıtları bulunan organizasyonlarda gerçekçi olmayabilir.
Ben daha odaklı bir başlangıç yaklaşımını tercih ediyorum. Öncelikle iş değeri açık bir kullanım senaryosu seçilmeli, ardından bu senaryonun ihtiyaç duyduğu kritik veriler belirlenmeli, mevcut veri kalitesi ölçülmeli ve uygulamanın güvenilir biçimde çalışabilmesi için gerekli eşikler tanımlanmalıdır. Sonrasında veri iyileştirmeleri kontrollü bir pilot çalışmayla gerçekleştirilmeli ve elde edilen sonuçlar değerlendirilerek kapsamın genişletilip genişletilmeyeceğine karar verilmelidir.
Bu yaklaşımın önemli avantajı, veri kalitesi çalışmalarının soyut bir teknik faaliyet olmaktan çıkarak somut bir iş hedefine bağlanmasıdır. Örneğin müşteri kaybını azaltmak isteyen bir şirketin bütün kurumsal veri kaynaklarını aynı anda yeniden yapılandırması gerekmeyebilir; öncelikle müşteri kimliği, işlem geçmişi, hizmet kullanımı ve müşteri etkileşimleri gibi kritik alanlardan başlanabilir.
Ancak pilot uygulamanın dar kapsamlı olması, veri güvenliği ve yönetişim gereksinimlerinin ertelenebileceği anlamına gelmez. Bence küçük başlamak, kontrolsüz başlamak değildir; aksine kapsamın bilinçli biçimde sınırlandırılması, kritik risklerin daha açık değerlendirilmesine ve elde edilen sonuçların daha sağlıklı ölçülmesine yardımcı olabilir.
Kurumlar için beş aşamalı bir veri hazırlığı yaklaşımı
Yapay zekâ yatırımlarında veri kalitesini geliştirmek isteyen kurumların, teknik hazırlık çalışmalarını iş hedefleriyle ilişkilendiren beş aşamalı bir yöntemle ilerlemesinin yararlı olabileceğini düşünüyorum. Bu yaklaşımın amacı yalnızca mevcut veri hatalarını gidermek değil, veri kalitesinin yatırımın bütün yaşam döngüsü boyunca yönetilebilmesini sağlamaktır.
1. İş problemini ve beklenen değeri tanımlayın
İlk aşamada yapay zekâdan beklenen iş sonucunun açık biçimde belirlenmesi gerekir. Hangi problemin çözülmek istendiği, mevcut performansın nasıl ölçüldüğü, yapay zekâ uygulamasının hangi kararı veya faaliyeti destekleyeceği ve başarının hangi göstergelerle değerlendirileceği netleştirilmeden veri hazırlama çalışmalarının kapsamını doğru belirlemek zorlaşır. Bu nedenle teknik ekiplerle iş birimlerinin aynı hedef üzerinde uzlaşmasını, veri kalitesi çalışmalarının başlangıç noktası olarak görüyorum.
2. Kritik veri kaynaklarını haritalayın
İkinci aşamada seçilen kullanım senaryosunun ihtiyaç duyduğu veriler belirlenmeli, bu verilerin hangi sistemlerde tutulduğu, nasıl oluşturulduğu ve hangi süreçlerden geçtiği incelenmelidir. Ayrıca verilerin hangi dönüşümlere uğradığının, hangi noktalarda manuel müdahale yapıldığının ve farklı sistemler arasında nasıl aktarıldığının anlaşılması gerekir. Bu çalışma, veri sorunlarının yalnızca sonuçlarını değil, olası nedenlerini de görünür hâle getirerek daha kalıcı iyileştirmeler yapılmasına yardımcı olabilir.
3. Veri kalitesini ölçün ve riskleri önceliklendirin
Üçüncü aşamada kritik veri alanları için doğruluk, tamlık, tutarlılık ve güncellik gibi ölçütler belirlenmeli; ancak bütün hataların aynı önceliğe sahip olmadığı kabul edilmelidir. Örneğin önemli bir satın alma kararını etkileyebilecek fiyat verisi hatasıyla, kullanılmayan bir açıklama alanındaki eksiklik aynı düzeyde değerlendirilmemelidir. Bu nedenle veri kalitesi sorunlarının iş etkisi, gerçekleşme olasılığı ve risk seviyesi dikkate alınarak önceliklendirilmesini önemli buluyorum.
4. Veri sahipliğini ve düzeltme mekanizmalarını oluşturun
Dördüncü aşamada belirlenen sorunların nasıl düzeltileceği ve bu faaliyetlerden kimin sorumlu olacağı açık biçimde tanımlanmalıdır. Hangi iş biriminin hangi veriden sorumlu olduğu, veri düzeltmelerini kimin gerçekleştireceği, kalite kurallarını kimin onaylayacağı ve istisnaların nasıl yönetileceği belirlenmeden yapılan tek seferlik veri temizliği çalışmaları kalıcı sonuç üretmeyebilir. Bu nedenle veri sahipliği ve düzeltme mekanizmalarının kurumun günlük işleyişinin bir parçası hâline getirilmesi gerekir.
5. Pilot uygulamayla sonuçları doğrulayın
Beşinci aşamada yapay zekâ uygulaması kontrollü bir ortamda test edilmeli ve veri kalitesi göstergeleriyle birlikte model performansı, insan kontrolü ihtiyacı, hata oranları ve iş sonuçları ölçülmelidir. Pilot uygulama başarılı olduğunda kapsamın genişletilmesi değerlendirilebilir; ancak uygulama büyüdükçe veri kaynaklarının, kullanım koşullarının ve risklerin değişebileceği unutulmamalıdır. Bu nedenle veri kalitesi yönetiminin yalnızca proje başlangıcında tamamlanan bir faaliyet değil, uygulamanın yaşam döngüsü boyunca devam eden bir sorumluluk olarak ele alınması gerektiğini düşünüyorum.
Yapay zekâ veri kalitesi sorunlarının çözümünde kullanılabilir mi?
Buraya kadar yapay zekâ sistemlerinin veri kalitesine olan bağımlılığını ele aldım; ancak konunun başka bir yönü daha bulunuyor. Yapay zekâ teknolojileri, veri kalitesi çalışmalarının geliştirilmesine ve belirli faaliyetlerin daha etkili gerçekleştirilmesine de yardımcı olabilir. Örneğin farklı sistemlerde bulunan benzer müşteri kayıtlarının eşleştirilmesinde makine öğrenmesi yöntemlerinden yararlanılabilir, anormal değerlerin tespit edilmesinde istatistiksel analizler ve yapay zekâ destekli yöntemler kullanılabilir, eksik veya tutarsız veri alanları için olası düzeltme önerileri hazırlanabilir ve veri sınıflandırma ile dokümantasyon çalışmalarında üretken yapay zekâ uygulamalarından destek alınabilir.
Bunların önemli fırsatlar olduğunu düşünüyorum; ancak yapay zekânın veri temizleme süreçlerinde kullanılması, ürettiği düzeltmelerin otomatik olarak doğru kabul edilmesini gerektirmez. Örneğin iki müşteri kaydının aynı kişiye veya şirkete ait olduğu tahmin edilebilir; ancak bu kayıtların yanlış birleştirilmesi finansal, hukuki veya operasyonel sorunlar oluşturabilir. Bu nedenle özellikle kritik veri düzeltmelerinde doğrulama kurallarının ve gerekli insan kontrollerinin korunması gerekir.
Benzer şekilde eksik verilerin tahmin edilerek doldurulması, bazı analitik çalışmalarda uygun bir yöntem olabilirken belirli operasyonel kayıtlar için kabul edilemez olabilir. Bu noktada da verinin kullanım amacı, hata riskinin büyüklüğü ve ilgili iş sürecinin gereksinimleri belirleyicidir. Bence yapay zekâ, veri kalitesi yönetiminde güçlü bir yardımcı olabilir; ancak veri kalitesinin sahipliğini, doğrulama sorumluluğunu ve kurumsal hesap verebilirliği ortadan kaldırmaz.
Kendi girişimcilik yolculuğumda veri kalitesine nasıl bakıyorum?
2026 yılında kurumsal çalışma hayatımdan ayrılarak Astrum Consulting Group'u geliştirmeye başladığımda, yıllardır büyük organizasyonlarda değerlendirdiğim bazı yönetim konularına girişimci bakış açısıyla da yaklaşma fırsatı buldum. Veri kalitesi bunlardan biri; çünkü büyük şirketlerde çok sayıda departmanı, sistemi ve çalışanı etkileyebilen veri sorunları, küçük girişimlerde daha sınırlı kaynaklarla yönetilmek zorunda kalabiliyor ve bu nedenle etkileri farklı biçimlerde hissedilebiliyor.
Bugün kendi girişimlerimi geliştirirken müşteri ilişkileri, pazar araştırması, satış fırsatları, içerik üretimi ve proje yönetimi gibi alanlarda farklı dijital araçlardan yararlanabiliyorum. Bu araçların her biri belirli bir ihtiyacı karşılayabilir; ancak oluşturdukları verilerin birbirleriyle nasıl ilişkilendirileceği, hangi bilgilerin güncel kabul edileceği ve kritik kayıtların nasıl yönetileceği benim için de önemli bir konu.
Örneğin potansiyel müşteri bilgilerinin farklı kaynaklardan toplandığını düşünelim. Aynı şirketin farklı isimlerle kaydedilmesi, iletişim bilgilerinin güncel olmaması veya görüşme geçmişinin eksik tutulması satış çalışmalarının etkinliğini azaltabilir. Bu veriler daha sonra yapay zekâ destekli bir müşteri önceliklendirme sisteminde kullanılırsa mevcut sorunlar analiz sonuçlarını da etkileyebilir. Benzer şekilde içerik üretimi ve pazarlama çalışmalarında kullanılan performans verilerinin tutarlı biçimde tanımlanması gerekir; çünkü bir platformdaki görüntülenme sayısıyla başka bir platformdaki etkileşim oranı aynı anlama gelmeyebilir ve bu göstergelerin doğrudan karşılaştırılması yanıltıcı sonuçlar oluşturabilir.
Bu nedenle kendi girişimlerimde de veri kalitesini yalnızca büyük şirketlerin çözmesi gereken bir konu olarak görmüyorum. Elbette gelişim aşamasındaki bir girişimde bütün veri süreçlerinin kurumsal ölçekte tasarlanması gerçekçi olmayabilir; ancak temel veri sahipliği, kayıt standartları, güncelleme kuralları ve ölçüm disiplininin erken dönemde oluşturulmasının ileride önemli faydalar sağlayabileceğini düşünüyorum.
Bence girişimcilikte önemli olan yalnızca hızlı hareket etmek ve yeni fırsatları değerlendirmek değil, girişim büyüdükçe güvenilir biçimde çalışabilecek bir yönetim altyapısı da oluşturabilmek. Kurumsal çalışma hayatımdan edindiğim deneyimlerin bugün kendi girişimlerimi geliştirirken bana hatırlattığı önemli konulardan biri, teknolojinin sağladığı hız kadar bu hızın hangi bilgiye ve hangi yönetim disiplinine dayandığının da önemli olduğudur.
Veri kalitesi gelecekte neden daha önemli olabilir?
Önümüzdeki yıllarda yapay zekâ uygulamalarının kurumsal süreçlerde daha fazla kullanılması olası görünüyor. Üretken yapay zekâ, gelişmiş analitik sistemleri ve yapay zekâ ajanları farklı iş süreçlerinde yeni kullanım alanları oluşturabilir; ancak bu gelişmelerin bütün sektörlerde aynı hızda ve aynı biçimde gerçekleşeceğini varsaymak doğru olmaz. Kurumların teknoloji altyapıları, düzenleyici gereksinimleri, yatırım kapasiteleri ve operasyonel ihtiyaçları birbirinden farklı olduğu için yapay zekâ uygulamalarının yaygınlaşma biçimleri de değişebilir.
Buna rağmen veri kalitesinin stratejik öneminin devam edeceğini düşünüyorum; çünkü yapay zekâ sistemleri daha fazla kurumsal veriyle etkileşime girdikçe veri kaynaklarının güvenilirliği, güncelliği ve izlenebilirliği önemini koruyacak. Örneğin gelecekte bir şirketin satış, üretim, finans ve satın alma süreçlerinde farklı yapay zekâ ajanları kullandığını düşünelim. Her ajan kendi görevini başarıyla yerine getirebilir; ancak ortak müşteri, ürün veya finansal veriler üzerinde tutarsızlıklar bulunuyorsa ajanların ürettiği sonuçlar arasında çelişkiler oluşabilir.
Böyle bir durumda yalnızca yapay zekâ ajanlarının teknik performansını geliştirmek yeterli olmayabilir. Ortak veri tanımlarının, erişim yetkilerinin ve süreçler arasındaki kontrol mekanizmalarının da geliştirilmesi gerekebilir. Bu nedenle yapay zekâ çağında veri yönetişiminin yalnızca bilgilerin saklanması, düzenlenmesi ve raporlanmasıyla sınırlı kalmayacağını, kurumların otomatik analiz ve işlem mekanizmalarını güvenilir biçimde yönetebilmesinin de önemli bir parçası hâline geleceğini düşünüyorum.
Sonuç: Yapay zekâ yatırımına başlamadan önce hangi soruyu sormalıyız?
Kurumsal çalışma hayatım boyunca teknoloji yatırımlarının şirketlere önemli fırsatlar sunduğunu gördüm. ERP sistemleri, iş zekâsı uygulamaları, otomasyon çözümleri, bulut teknolojileri ve bugün yapay zekâ, kurumların iş yapma biçimlerini geliştirmek, süreçlerini daha etkin yönetmek ve daha iyi kararlar almak için farklı imkânlar oluşturuyor. Ancak bütün bu teknolojilerin ortak bir gereksinimi bulunuyor: Doğru iş problemlerine, güvenilir verilere ve açık yönetim sorumluluklarına ihtiyaç duyuyorlar.
Yapay zekâ yatırımlarında bu ilişkinin daha da önemli hâle geldiğini düşünüyorum; çünkü yapay zekâ yalnızca mevcut bilgileri raporlamak için değil, tahmin üretmek, öneriler geliştirmek ve belirli işlemleri desteklemek için de kullanılabiliyor. Bu nedenle veri kalitesini yalnızca projenin teknik hazırlık aşamasında tamamlanması gereken bir faaliyet olarak değil, yatırımın ekonomik değerini, operasyonel güvenilirliğini ve sürdürülebilirliğini etkileyebilecek temel bir yönetim konusu olarak değerlendiriyorum.
Bence başarılı bir kurumsal yapay zekâ yatırımı için dört unsurun birlikte ele alınması gerekiyor: Çözülmek istenen iş probleminin açık biçimde tanımlanması, bu problem için gerekli verilerin yeterince güvenilir olması, veri ve karar sorumluluklarının belirlenmesi ve yatırımın gerçek iş sonuçlarının ölçülmesi. Bu unsurlardan biri eksik olduğunda teknoloji yatırımından beklenen fayda sınırlı kalabilir; çünkü gelişmiş bir yapay zekâ modelinin kullanılması, tek başına doğru iş probleminin çözüldüğünü veya kurumun güvenilir kararlar alabildiğini göstermez.
Bugün kendi girişimlerimi geliştirirken de aynı düşünceden hareket ediyorum. Yeni bir teknolojiye yatırım yapmadan önce yalnızca o teknolojinin neler yapabildiğini değil, mevcut verilerimin ve çalışma biçimimin bu teknolojiden değer üretmeye ne kadar hazır olduğunu sorgulamaya çalışıyorum. Çünkü teknoloji yatırımlarının amacı en gelişmiş sistemlere sahip olmak değil, daha iyi iş sonuçları elde etmek olmalı.
Yapay zekâ yatırımlarında rekabet avantajını yalnızca en güçlü modelleri kullanan şirketlerin değil, bu modelleri güvenilir verilerle, doğru yönetim mekanizmalarıyla ve açık iş hedefleriyle destekleyen şirketlerin elde edebileceğini düşünüyorum. Bu nedenle yapay zekâya hazırlık değerlendirmelerinin yalnızca teknoloji altyapısını veya çalışanların yeni araçları kullanma becerisini ölçmekle sınırlı kalmaması, kurumun güvenilir veri üretme ve yönetme kapasitesini de kapsaması gerektiğine inanıyorum.
Yazıyı özellikle CEO'lara, CIO'lara, COO'lara ve kurumsal dönüşüm yöneticilerine yöneltmek istediğim bir soruyla tamamlamak istiyorum:
Şirketinizin yapay zekâ yatırımlarına ne kadar hazır olduğunu biliyor olabilirsiniz. Peki, bu yatırımların temelini oluşturacak kritik verilerin ne kadarına gerçekten güvenebileceğinizi aynı açıklıkla söyleyebilir misiniz?
Bilgin Çavuş
Kurumsal Dönüşüm Stratejisti | Teknoloji Girişimcisi | Yazar
Kurucu ve Yönetici Ortak — Astrum Consulting Group
Bu yazı, kurumsal çalışma hayatımdan edindiğim deneyimler, teknoloji ve yönetişim alanındaki değerlendirmelerim ve girişimcilik yolculuğum çerçevesinde oluşturduğum kişisel görüşleri içermektedir. Kullanılan kurumsal senaryolar açıklama amaçlı varsayımsal örneklerdir. Sayısal örnekler gerçek bir şirketin ölçülmüş performansını temsil etmemektedir.
Konuyla ilgili kaynaklar ve ileri okumalar
1. ISO/IEC 25012 — Data Quality Model
Veri kalitesinin doğruluk, tamlık, tutarlılık ve diğer özellikler üzerinden değerlendirilmesine yönelik referans model.
https://www.iso.org/standard/35736.html
2. DAMA International — DAMA-DMBOK
Kurumsal veri yönetimi, veri yönetişimi, ana veri yönetimi ve veri kalitesi uygulamalarına ilişkin başvuru çerçevesi.
https://www.dama.org/
3. NIST — Artificial Intelligence Risk Management Framework 1.0
Yapay zekâ sistemlerinin güvenilirliği, risklerinin belirlenmesi, ölçülmesi ve yönetilmesine yönelik çerçeve.
https://www.nist.gov/itl/ai-risk-management-framework
4. NIST — AI RMF Generative AI Profile
Üretken yapay zekâ sistemlerine özgü risklerin değerlendirilmesi ve yönetilmesine ilişkin tamamlayıcı kaynak.
https://www.nist.gov/itl/ai-risk-management-framework
5. ISO/IEC 42001 — Artificial Intelligence Management System
Kuruluşlarda yapay zekâ yönetim sistemlerinin oluşturulması ve sürekli iyileştirilmesine yönelik uluslararası standart.
https://www.iso.org/standard/81230.html
Bu kaynaklar makalede ele alınan kavramsal yaklaşımlar için başvuru niteliğindedir. Makaledeki kişisel değerlendirmeler, önerilen yedi boyutlu değerlendirme yaklaşımı ve varsayımsal örnekler bu kuruluşların doğrudan araştırma bulguları olarak sunulmamaktadır.