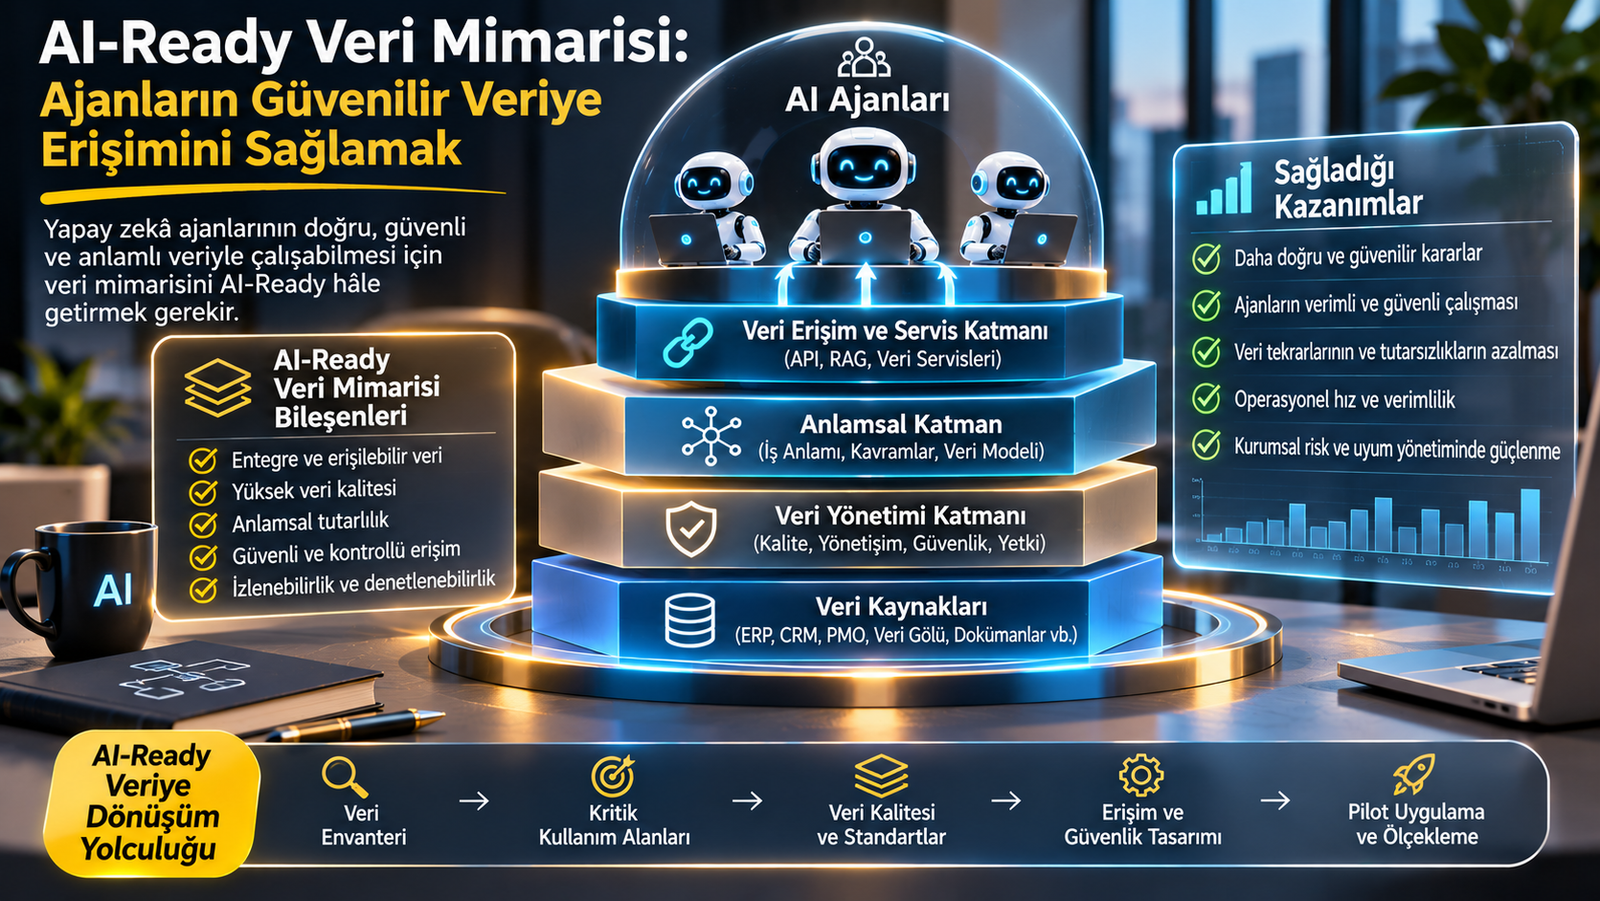
Yapay zekâ ajanlarının kurumsal operasyonlarda gerçek sorumluluk üstlenmeye başladığı bir dönemde, şirketlerin karşı karşıya olduğu en önemli sorunlardan birinin model seçimi değil, veri mimarisi olduğunu düşünüyorum. Çünkü bir AI ajanının ne kadar gelişmiş olduğu, hangi araçları kullanabildiği veya kaç farklı görevi yerine getirebildiği, eriştiği verilerin doğruluğu, güncelliği, anlamı ve güvenilirliği kadar önemlidir. Yanlış veriye dayanan bir analiz, eksik bağlamla oluşturulan bir öneri veya yetkisiz erişimle gerçekleştirilen bir işlem, teknolojik açıdan başarılı görünse bile kurumsal açıdan başarısız olabilir. Bu nedenle AI-Ready veri mimarisini yalnızca yapay zekâ projelerini destekleyen teknik bir altyapı olarak değil, geleceğin işletme modelinin temel bileşenlerinden biri olarak değerlendiriyorum.
Yapay Zekâ Çağında Asıl Sorun Verinin Miktarı Değil, Kullanılabilirliği
Kurumsal dönüşüm projelerinde uzun yıllardır karşılaştığım önemli sorunlardan biri, şirketlerin çok büyük miktarda veriye sahip olmalarına rağmen bu verileri karar süreçlerinde yeterince etkin kullanamamalarıdır. ERP sistemleri, müşteri ilişkileri yönetimi uygulamaları, proje yönetim platformları, finansal sistemler, insan kaynakları uygulamaları ve operasyonel veri kaynakları sürekli bilgi üretir. Ancak bu bilgilerin farklı sistemlerde bulunması, birbirleriyle tutarlı olmaması veya iş bağlamından kopuk biçimde saklanması, organizasyonların veriden değer üretmesini zorlaştırabilir.
Geleneksel veri analitiği projelerinde bu sorun çoğu zaman raporlama ve karar desteği açısından değerlendirilirdi. Bir yönetici yanlış veya eksik bir raporla karşılaştığında ek bilgi isteyebilir, farklı kaynakları karşılaştırabilir veya analizin yeniden hazırlanmasını talep edebilirdi. Bu kontrollerin her zaman yeterli olduğunu söylemek mümkün değildir; ancak insan değerlendirmesi, karar sürecinin önemli bir parçasıydı.
AI ajanlarının kurumsal operasyonlara katılmasıyla birlikte veri kalitesinin etkisi farklı bir boyut kazanıyor.
Çünkü bir yapay zekâ ajanı yalnızca verileri analiz ederek rapor üretmeyebilir. Belirli koşullarda bu verilere dayanarak iş akışlarını başlatabilir, görevleri başka ajanlara devredebilir, sistemlerde kayıt oluşturabilir veya tanımlanmış yetkileri kapsamında işlemleri gerçekleştirebilir.
Örneğin bir satın alma ajanının stok verilerindeki tutarsızlığı fark edememesi, gereksiz satın alma önerilerine neden olabilir. Bir satış ajanının güncel olmayan fiyatlandırma bilgilerini kullanması, ticari açıdan hatalı tekliflerin hazırlanmasına yol açabilir. Bir proje yönetimi ajanının kaynak kapasitesini yanlış yorumlaması ise gerçekçi olmayan proje planları oluşturabilir.
Burada dikkat çekmek istediğim nokta, yapay zekânın bu sorunları mutlaka artıracağı değildir. Doğru tasarlandığında AI sistemleri veri kalitesi problemlerinin belirlenmesine de yardımcı olabilir. Ancak hatalı verilerin otomatik işlemlere dönüşmesi, yanlışlıkların etkisini ve yayılma hızını artırabilir.
Benim açımdan bu nedenle kurumsal yapay zekâ dönüşümünün başlangıç sorusu yalnızca “Hangi AI modelini kullanmalıyız?” olmamalıdır.
Daha temel soru şudur: Yapay zekâ ajanlarımızın doğru, güncel, yetkilendirilmiş ve iş bağlamı açık verilere güvenilir biçimde erişebileceği bir mimarimiz var mı?
AI-Ready Veri Mimarisi Nedir?
AI-Ready veri mimarisini, kurumsal verilerin yapay zekâ uygulamaları ve ajanları tarafından güvenilir, kontrollü, anlamlı ve sürdürülebilir biçimde kullanılmasını sağlayan veri yönetimi ve erişim yaklaşımı olarak tanımlıyorum.
Bu tanımın özellikle önemli olduğunu düşünüyorum. Çünkü AI-Ready kavramını yalnızca verilerin büyük dil modellerine aktarılabilecek formatlara dönüştürülmesiyle sınırlandırmak doğru değildir.
Bir veri kümesinin teknik olarak bir yapay zekâ modeli tarafından okunabilmesi, o verinin kurumsal kullanım için hazır olduğu anlamına gelmez.
Örneğin bir şirketin bütün satış kayıtları merkezi bir veri platformunda bulunabilir. Ancak müşteri tanımları tutarsızsa, para birimleri doğru yönetilmiyorsa, satış durumları farklı departmanlarda farklı anlamlara geliyorsa veya verilere erişim yetkileri yeterince sınırlandırılmamışsa, bu platformun AI ajanları için güvenilir bir kaynak olduğu söylenemez.
AI-Ready veri mimarisi bu nedenle veri entegrasyonu, veri kalitesi, veri yönetişimi, anlamsal tutarlılık, güvenlik, erişim kontrolü ve operasyonel izlenebilirlik gibi birden fazla boyutu birlikte ele almalıdır.
Bununla birlikte bütün kurumların aynı teknoloji mimarisini kullanması gerektiğini düşünmüyorum.
Bazı organizasyonlarda mevcut veri ambarı ve API altyapısının geliştirilmesi yeterli olabilir. Bazılarında veri gölü, lakehouse veya veri sanallaştırma yaklaşımları uygun olabilir. Daha karmaşık yapılarda ise farklı veri ürünlerinin ortak yönetişim ilkeleriyle yönetildiği dağıtık mimariler değerlendirilebilir.
Benim açımdan önemli olan teknoloji kategorisinin adı değil, mimarinin kurumsal kullanım senaryolarını güvenilir biçimde destekleyebilmesidir.
Geleneksel Veri Mimarisi AI Ajanları İçin Neden Her Zaman Yeterli Değildir?
Geleneksel kurumsal veri mimarilerinin önemli bir bölümü, raporlama, analitik ve belirli uygulamalar arasında veri paylaşımı ihtiyaçları doğrultusunda geliştirilmiştir.
Bu mimariler birçok yapay zekâ uygulaması için de kullanılabilir. Dolayısıyla AI ajanlarının devreye alınması, mevcut veri altyapısının mutlaka değiştirilmesini gerektirmez.
Ancak ajan tabanlı sistemler, mevcut mimarilerin daha önce yeterince dikkate alınmamış bazı sınırlılıklarını görünür hâle getirebilir.
Örneğin bir raporlama sistemi için günlük veri güncellemesi yeterli olabilir. Ancak müşteri siparişlerinin mevcut durumuna göre işlem gerçekleştiren bir ajan için daha güncel bilgi gerekebilir.
Bir veri ambarındaki özet satış verileri, yönetsel analiz için yeterli olabilir. Ancak belirli bir müşteri siparişinin neden geciktiğini araştıran ajan, işlem düzeyindeki ayrıntılara ve ilgili operasyonel sistemlere erişmek zorunda kalabilir.
Benzer biçimde geleneksel raporlama uygulamalarında veri erişimi çoğunlukla önceden hazırlanmış raporlar üzerinden gerçekleşirken, AI ajanları görev bağlamına göre farklı bilgi kaynaklarına başvurabilir.
Bu durum veri erişiminin daha dinamik hâle gelmesine neden olur.
Ancak dinamik erişim, kontrolsüz erişim anlamına gelmemelidir.
Benim açımdan AI-Ready veri mimarisinin temel gereksinimlerinden biri, esnek bilgi erişimiyle kurumsal güvenlik ve yönetişim kurallarını birlikte uygulayabilmektir.
Veri Kalitesi: AI Ajanlarının Karar Güvenilirliğinin Başlangıç Noktası
Kurumsal veri yönetiminde doğruluk, bütünlük, tutarlılık, güncellik ve uygunluk gibi veri kalitesi boyutları uzun süredir kullanılmaktadır.
Bu boyutlar AI ajanları açısından da önemini koruyor.
Ancak veri kalitesinin yalnızca teknik bir temizlik faaliyeti olarak değerlendirilmesini yeterli bulmuyorum.
Örneğin bir müşteri kaydındaki adres bilgisinin eksik olması, bazı analizlerde sınırlı etki oluşturabilirken lojistik planlama yapan bir ajan açısından kritik olabilir.
Bir proje kaydındaki tamamlanma oranının güncel olmaması, aylık raporlamada belirli bir gecikme yaratabilir. Ancak bu veriye dayanarak kaynak dağılımı öneren bir ajan için daha önemli sonuçlar doğurabilir.
Dolayısıyla veri kalitesi, kullanım bağlamından bağımsız olarak değerlendirilemez.
Benim açımdan doğru yaklaşım, veri kalitesi gereksinimlerini ilgili iş kararları ve operasyonel süreçlerle ilişkilendirmektir.
Bir veri alanının hangi doğruluk düzeyinde olması gerektiği, ne sıklıkla güncellenmesi gerektiği veya hangi kontrollerden geçmesi gerektiği, o verinin hangi işlemlerde kullanılacağına göre belirlenmelidir.
Özellikle otomatik işlem gerçekleştiren ajanlarda veri kalitesi kontrollerinin yalnızca periyodik raporlarla sınırlı kalmaması gerekir.
Kritik işlemlerden önce gerekli verilerin uygunluğu doğrulanabilir. Eksik veya tutarsız bilgi tespit edildiğinde ajan işlemi durdurabilir, alternatif doğrulanmış kaynağa başvurabilir veya insan değerlendirmesi isteyebilir.
Ancak bütün veri kalitesi sorunlarının yapay zekâ tarafından otomatik çözülebileceğini varsaymıyorum.
Verinin doğru olup olmadığını belirlemek için kimi zaman iş süreci bilgisine, kaynak sistem doğrulamasına veya yetkili insan değerlendirmesine ihtiyaç duyulur.
Bu nedenle veri kalitesinin sorumluluğu yalnızca AI platformuna bırakılamaz.
Anlamsal Tutarlılık: Ajanlar Veriyi Okumakla Kalmamalı, Doğru Yorumlamalı
AI-Ready veri mimarisinin en önemli boyutlarından birinin anlamsal tutarlılık olduğunu düşünüyorum.
Kurumsal sistemlerde aynı kavramın farklı departmanlarda farklı biçimlerde tanımlanması oldukça yaygın bir sorundur.
Örneğin satış departmanı için aktif müşteri, son belirli dönemde sipariş veren müşteri olabilir. Finans departmanı ise aktif müşteriyi açık bakiyesi veya devam eden sözleşmesi bulunan müşteri olarak değerlendirebilir.
Benzer biçimde proje tamamlanma oranı, bazı ekiplerde gerçekleştirilen faaliyetlerin oranını ifade ederken başka ekiplerde teslimatların kabul durumuna göre hesaplanabilir.
İnsan çalışanlar bu farklılıkları çoğu zaman organizasyonel deneyimleri sayesinde fark edebilir.
Ancak bir AI ajanı, hangi tanımın geçerli olduğunu bilmeden farklı sistemlerden gelen bilgileri birleştirirse, teknik olarak tutarlı görünen fakat iş açısından yanlış sonuçlar oluşturabilir.
Bu nedenle kurumsal kavramların, metriklerin ve veri ilişkilerinin açık biçimde tanımlanması gerektiğini düşünüyorum.
Semantik katmanlar, iş sözlükleri, veri katalogları ve gerektiğinde ontoloji veya bilgi grafiği yaklaşımları bu amaçla kullanılabilir.
Ancak burada da teknolojiye gereğinden fazla anlam yüklememek gerekir.
Bir bilgi grafiği oluşturmak, kurumun bütün anlamsal tutarsızlıklarını kendiliğinden çözmez.
Öncelikle ilgili iş kavramlarının kim tarafından tanımlandığı, hangi koşullarda geçerli olduğu ve değişikliklerin nasıl yönetildiği belirlenmelidir.
Benim açımdan anlamsal veri mimarisi, teknik sistemlerin aynı veriyi paylaşmasından daha kapsamlıdır.
Organizasyonun aynı iş kavramlarını tutarlı biçimde kullanabilmesini sağlamaktır.
AI Ajanları Veriye Doğrudan mı, Kontrollü Bir Katman Üzerinden mi Erişmeli?
Yapay zekâ ajanları için veri erişimi tasarlarken en önemli mimari kararlardan biri, ajanların kaynak sistemlere hangi yöntemle bağlanacağıdır.
Bir yaklaşım, ajanın ilgili veri kaynağına doğrudan erişmesidir.
Bu yaklaşım bazı basit ve kontrollü kullanım senaryolarında uygun olabilir. Ancak kurumsal ölçekte çok sayıda ajanın farklı sistemlere doğrudan bağlanması, erişim yönetimi ve denetim açısından karmaşıklık oluşturabilir.
Alternatif yaklaşım, veri erişiminin belirli API'ler, veri servisleri veya yönetişim kontrolleri bulunan erişim katmanları üzerinden gerçekleştirilmesidir.
Bu tür bir yapı, hangi verilerin hangi koşullarda kullanılabileceğini daha merkezi ve tutarlı biçimde yönetmeye yardımcı olabilir.
Örneğin müşteri analiz ajanının CRM veritabanındaki bütün tablolara erişmesi yerine, yalnızca görevi için gerekli müşteri bilgilerini sunan bir servisi kullanması tercih edilebilir.
Benzer biçimde bir proje yönetimi ajanı, proje veritabanına sınırsız erişim yerine tanımlanmış proje durum servislerinden yararlanabilir.
Ancak bütün veri erişimlerinin tek bir merkezi servis üzerinden gerçekleştirilmesi de her durumda en uygun çözüm değildir.
Böyle bir tasarım, gereksiz bağımlılık ve performans darboğazları oluşturabilir.
Benim açımdan doğru mimari, veri kaynaklarının özelliklerine ve kullanım senaryolarına göre farklı erişim yöntemlerini desteklerken ortak güvenlik, yetkilendirme ve izlenebilirlik ilkelerini koruyabilen mimaridir.
Retrieval-Augmented Generation: Kurumsal Bilgiye Dayalı AI
Büyük dil modellerinin kurumsal bilgi kaynaklarıyla birlikte kullanılmasında öne çıkan yaklaşımlardan biri Retrieval-Augmented Generation, yani RAG mimarisidir.
RAG yaklaşımında sistem, belirli bir soruya veya göreve yanıt oluştururken ilgili bilgileri dış kaynaklardan getirerek modelin kullanımına sunabilir.
Bu yöntem, kurumsal dokümanların, prosedürlerin, teknik bilgilerin ve diğer bilgi kaynaklarının AI uygulamalarında değerlendirilmesine yardımcı olabilir.
Örneğin bir danışmanlık ajanı, kurumsal metodoloji dokümanlarından ilgili bölümleri getirerek bir değerlendirme taslağı hazırlayabilir.
Bir insan kaynakları ajanı, şirket politikalarının güncel sürümlerine başvurarak çalışanların sorularını yanıtlayabilir.
Bir teknik destek ajanı, ürün dokümantasyonu ve bilgi tabanındaki kayıtları kullanarak çözüm önerileri oluşturabilir.
Ancak RAG kullanılması, sistemin otomatik olarak güvenilir sonuçlar üreteceği anlamına gelmez.
Yanlış dokümanların getirilmesi, güncel olmayan bilgilerin kullanılması, ilgili bağlamın eksik kalması veya erişim kontrollerinin yetersiz olması durumunda sistem yine hatalı sonuçlar oluşturabilir.
Bu nedenle RAG mimarisinin yalnızca vektör veritabanı ve benzerlik araması üzerinden değerlendirilmesini doğru bulmuyorum.
Doküman yaşam döngüsü, kaynak güvenilirliği, erişim izinleri, veri güncelliği, geri getirme kalitesi ve yanıt doğrulama mekanizmaları birlikte ele alınmalıdır.
Benim açımdan RAG, kurumsal bilgi mimarisinin yerine geçen bir çözüm değildir.
Doğru tasarlandığında mevcut bilgi yönetimi kapasitesini AI uygulamalarına taşıyan önemli bir erişim yöntemidir.
Yapılandırılmış Veri ile Kurumsal Dokümanların Birlikte Kullanılması
Kurumsal bilgi yalnızca veritabanlarında bulunmaz.
Sözleşmeler, teknik dokümanlar, prosedürler, toplantı kayıtları, proje raporları, e-postalar ve diğer belgeler de önemli bilgi kaynaklarıdır.
AI ajanlarının güvenilir biçimde çalışabilmesi için yapılandırılmış ve yapılandırılmamış verilerin uygun yöntemlerle birlikte kullanılabilmesi gerekir.
Örneğin bir proje risk ajanı, proje yönetim sistemindeki gecikme göstergelerini inceleyebilir.
Ancak gecikmenin nedenlerini değerlendirmek için toplantı tutanaklarına, değişiklik taleplerine veya teknik risk raporlarına da ihtiyaç duyabilir.
Benzer biçimde bir satış ajanı, CRM sistemindeki müşteri bilgilerini kullanırken sözleşme dokümanlarındaki özel koşulları da değerlendirmek zorunda kalabilir.
Bu nedenle farklı bilgi türlerinin ilişkili iş nesneleri üzerinden bağlanabilmesi önemlidir.
Ancak yapılandırılmış verilerle dokümanlardan çıkarılan bilgilerin aynı güvenilirlik düzeyinde değerlendirilmemesi gerekir.
Bir ERP sistemindeki doğrulanmış sipariş durumu ile güncel olmayan bir toplantı notunda yer alan sipariş bilgisi çelişebilir.
Böyle bir durumda hangi kaynağın öncelikli olduğu, iş süreci ve veri yönetişimi kurallarıyla belirlenmelidir.
Benim açımdan AI-Ready veri mimarisinin önemli özelliklerinden biri, yalnızca çok sayıda kaynağa erişim sağlamak değil, kaynaklar arasındaki güvenilirlik ve öncelik ilişkilerini de yönetebilmektir.
Gerçek Zamanlı Veri Her AI Ajanı İçin Gerekli mi?
Kurumsal yapay zekâ projelerinde sık karşılaştığım yaklaşımlardan biri, bütün sistemlerin gerçek zamanlı veriyle çalışması gerektiği düşüncesidir.
Ancak bunun her kullanım senaryosu için gerekli veya ekonomik olduğunu düşünmüyorum.
Örneğin aylık stratejik performans değerlendirmesi hazırlayan bir ajan için belirli aralıklarla güncellenen veriler yeterli olabilir.
Buna karşılık stok rezervasyonu, sipariş durumu veya operasyonel kapasiteye göre işlem gerçekleştiren bir ajan için daha güncel veri gerekebilir.
Bu nedenle veri güncelliği gereksiniminin iş sürecine göre tanımlanması gerekir.
Gerçek zamanlı veri mimarileri, olay tabanlı entegrasyonlar ve akış işleme teknolojileri belirli kullanım alanlarında önemli avantajlar sağlayabilir.
Ancak bu yaklaşımların işletme maliyeti, teknik karmaşıklığı ve yönetim gereksinimleri de bulunur.
Benim açımdan önemli olan, mümkün olan en düşük gecikmeye ulaşmak değil; kararın gerektirdiği veri güncelliğini güvenilir biçimde sağlayabilmektir.
Ayrıca bir verinin teknik olarak yeni olması, mutlaka doğru olduğu anlamına gelmez.
Yanlış kaydedilmiş bir işlemin anında AI ajanına aktarılması, veri kalitesi problemini çözmez.
Dolayısıyla güncellik, doğruluk ve iş bağlamı birlikte değerlendirilmelidir.
Veri Güvenliği: Ajanın Görebildiği Her Veri Kullanılabilir Olmamalı
AI ajanlarının kurumsal veri kaynaklarına erişmesi, güvenlik ve gizlilik açısından önemli sorumluluklar oluşturur.
Bir ajanın belirli bir görevi gerçekleştirmek için müşteri bilgilerine ihtiyaç duyması, bütün müşteri kayıtlarına erişmesi gerektiği anlamına gelmez.
Benzer biçimde finansal analiz gerçekleştiren bir ajanın belirli maliyet verilerini kullanması, bütün finansal işlemleri görüntüleyebilmesini veya değiştirebilmesini gerektirmez.
Bu nedenle veri erişiminde en az ayrıcalık, görev bazlı yetkilendirme ve veri minimizasyonu ilkelerinin uygulanması gerektiğini düşünüyorum.
Özellikle AI ajanlarının farklı araçları kullanabildiği ortamlarda erişim kontrolünün yalnızca model talimatlarıyla sınırlandırılması yeterli değildir.
Veri servisleri, API'ler ve kaynak sistemler üzerinde teknik yetkilendirme kontrolleri bulunmalıdır.
Ayrıca bir ajanın belirli verileri okuyabilmesi, bu verileri başka bir sisteme aktarma yetkisine sahip olduğu anlamına gelmez.
Bu nedenle veri kullanım ve aktarım izinleri de değerlendirilmelidir.
Benim açımdan güvenilir AI veri mimarisinin temel ilkelerinden biri, erişim yetkisinin görev bağlamına uygun olarak belirlenmesi ve uygulanmasıdır.
Veri Soy Ağacı: Ajanın Kullandığı Bilginin Kaynağı Bilinmeli
Veri soy ağacı olarak ifade edilen data lineage yaklaşımı, verinin hangi kaynaklardan geldiğinin, hangi dönüşümlerden geçtiğinin ve hangi sistemlerde kullanıldığının izlenmesine yardımcı olur.
Bu yaklaşımın AI ajanları için önemli olduğunu düşünüyorum.
Örneğin bir finans ajanı belirli bir kârlılık analizi oluşturduğunda, kullanılan gelir ve maliyet bilgilerinin hangi kaynak sistemlerden geldiği değerlendirilebilmelidir.
Bir proje portföyü ajanı kaynak kapasitesi analizi hazırladığında, kullanılan personel ve proje bilgilerinin hangi tarihte güncellendiği ve hangi hesaplama kurallarıyla birleştirildiği anlaşılabilmelidir.
Ancak veri soy ağacı bulunması, verinin mutlaka doğru olduğunu kanıtlamaz.
Bir veri yanlış kaydedilmiş olabilir veya doğru bir kaynaktan gelen bilgi yanlış bir iş kuralıyla dönüştürülmüş olabilir.
Bu nedenle data lineage, veri kalitesi ve iş kurallarıyla birlikte ele alınmalıdır.
Benim açımdan bu yaklaşımın en önemli katkısı, AI ajanının ürettiği sonucun hangi bilgi kaynaklarıyla ilişkili olduğunun değerlendirilmesini kolaylaştırmasıdır.
Bu ilişki, hem denetlenebilirlik hem de hataların nedenlerini araştırmak açısından değerli olabilir.
SAP ve ERP Sistemlerinde AI-Ready Veri Mimarisi
SAP ve diğer ERP sistemleri, birçok organizasyonda kritik operasyonel verilerin temel kaynakları arasında yer alır.
Finansal kayıtlar, satın alma işlemleri, malzeme hareketleri, üretim planları, müşteri siparişleri ve diğer önemli bilgiler bu sistemlerde yönetilir.
AI ajanlarının ERP süreçlerine katılması, bu verilerin daha etkin değerlendirilmesine yardımcı olabilir.
Ancak ERP sistemlerine doğrudan ve geniş kapsamlı erişim verilmesini doğru bulmuyorum.
Örneğin bir SAP satın alma ajanı, malzeme ihtiyaçlarını analiz etmek için belirli stok ve tedarik bilgilerine erişebilir.
Ancak bu ajanın bütün ERP tablolarına erişmesi veya kontrolsüz biçimde satın alma siparişi oluşturması gerekli değildir.
Benzer biçimde bir SAP finans ajanı, muhasebe kayıtlarını analiz edebilir; ancak finansal kayıtları değiştirme yetkisi ayrı değerlendirilmelidir.
Bu nedenle ERP ortamlarında AI-Ready veri mimarisinin mevcut iş kuralları, yetkilendirme mekanizmaları ve veri sahipliği yapısıyla uyumlu biçimde tasarlanması gerekir.
SAP uygulamalarında kullanılabilecek standart API'ler, uygun entegrasyon servisleri ve iş nesnesi tabanlı erişim yöntemleri, kullanım senaryosuna göre değerlendirilebilir.
Ancak bütün SAP sistemlerinin aynı teknik mimariye sahip olduğunu varsaymamak gerekir.
Kullanılan ürünler, sürümler, özelleştirmeler ve mevcut entegrasyon altyapısı çözüm tasarımını etkiler.
Benim açımdan ERP sistemlerinde AI veri erişiminin temel hedefi, mevcut operasyonel kontrolleri devre dışı bırakmak değil; güvenilir kurumsal verileri kontrollü biçimde AI kullanımına açmaktır.
PMO ve Portföy Yönetiminde Güvenilir Veri Neden Kritik?
Proje yönetimi ve PMO alanında veri mimarisinin önemi, karar kalitesiyle doğrudan ilişkilidir.
Bir proje portföyünün durumu hakkında güvenilir değerlendirme yapılabilmesi için proje takvimleri, bütçeler, kaynak kapasitesi, riskler ve stratejik hedeflerle ilişkili verilerin tutarlı olması gerekir.
Ancak birçok organizasyonda bu bilgiler farklı uygulamalarda tutulur.
Proje planları bir sistemde, finansal gerçekleşmeler ERP ortamında, kaynak kapasitesi başka bir uygulamada ve risk kayıtları farklı dosyalarda bulunabilir.
AI destekli PMO uygulamaları bu kaynakları birlikte değerlendirme potansiyeli taşır.
Ancak veriler arasındaki ilişkiler doğru kurulmadığında, daha hızlı analiz yapılması daha doğru karar verileceği anlamına gelmez.
Örneğin bir AI ajanı belirli bir projenin bütçe sapmasını analiz edebilir.
Ancak bütçe verileri farklı para birimlerinde tutuluyorsa, gerçekleşme tarihleri tutarsızsa veya proje kapsamındaki değişiklikler hesaba katılmıyorsa, ortaya çıkan analiz yanıltıcı olabilir.
Bu nedenle AI destekli karar istihbaratının güvenilir veri mimarisiyle birlikte geliştirilmesi gerektiğini düşünüyorum.
Benim açımdan PMO'nun gelecekteki rolü yalnızca proje verilerini toplamak olmayacak.
Aynı zamanda karar süreçlerinde kullanılan verilerin güvenilirliğini, tanımlarını ve iş bağlamını yönetmek de önemli bir yetkinlik hâline gelecek.
Veri Sahipliği: AI Ajanları Verinin Sorumluluğunu Üstlenebilir mi?
AI-Ready veri mimarisi üzerine düşünürken özellikle üzerinde durduğum konulardan biri veri sahipliğidir.
Bir AI ajanı veriyi okuyabilir, analiz edebilir, sınıflandırabilir ve belirli koşullarda güncelleyebilir.
Ancak bu faaliyetler, verinin kurumsal sorumluluğunun ajana devredildiği anlamına gelmez.
Örneğin müşteri verilerinin iş açısından doğru tanımlanması satış veya müşteri yönetimi fonksiyonlarının sorumluluğunda olabilir.
Finansal verilerin doğruluğu ve ilgili kontroller finans fonksiyonlarıyla ilişkilendirilebilir.
Proje verilerinin güncelliği ve değerlendirme kuralları ise proje yöneticileri ve PMO tarafından yönetilebilir.
Bu nedenle veri sahipliği ve veri yönetişimi rollerinin AI ajanlarıyla birlikte yeniden değerlendirilmesi gerektiğini düşünüyorum.
Ajanlar veri kalitesi sorunlarını tespit edebilir, düzeltme önerileri oluşturabilir veya yetkilendirilmiş standart işlemleri gerçekleştirebilir.
Ancak veri tanımlarının, kalite beklentilerinin ve kritik değişikliklerin kurumsal sahipliği insan rollerinde kalmalıdır.
Benim açımdan AI-Ready veri mimarisinin başarısı yalnızca teknik entegrasyonlara bağlı değildir.
Veri sahiplerinin, süreç sahiplerinin ve teknoloji ekiplerinin ortak bir yönetişim yaklaşımı içinde çalışmasına da bağlıdır.
AI-Ready Veri Mimarisi İçin Nasıl Bir İşletme Modeli Gerekli?
Kurumsal ölçekte AI ajanları geliştirmek isteyen şirketlerin veri mimarisini yalnızca BT departmanının sorumluluğunda değerlendirmelerini yeterli bulmuyorum.
Çünkü veri kalitesi, anlamsal tutarlılık ve veri sahipliği gibi konular doğrudan iş süreçleriyle ilişkilidir.
Bu nedenle AI-Ready veri mimarisinin oluşturulması, teknoloji ekipleriyle iş birimleri arasında ortak sorumluluk gerektirir.
Benim açımdan veri mimarisi yönetiminde öncelikle kritik veri alanları ve iş süreçleri belirlenmelidir.
Daha sonra bu alanların sahipleri, kalite gereksinimleri, erişim kuralları ve güncelleme sorumlulukları tanımlanmalıdır.
Teknoloji ekipleri veri entegrasyonlarını, güvenlik kontrollerini ve teknik erişim mekanizmalarını geliştirebilir.
İş birimleri ise veri tanımlarının ve kullanım kurallarının doğruluğundan sorumlu olabilir.
Risk, güvenlik ve uyum fonksiyonları da ilgili kontrol gereksinimlerinin değerlendirilmesine katkı sağlayabilir.
Ancak bütün bu sorumlulukların yalnızca organizasyon şemasında tanımlanması yeterli değildir.
Gerçek iş akışlarında nasıl uygulanacaklarının da belirlenmesi gerekir.
Benim açımdan geleceğin veri işletme modeli, verinin kim tarafından yönetildiğini açıklamakla kalmamalı; insanlarla AI ajanlarının bu verileri hangi koşullarda kullanabileceğini de düzenlemelidir.
AI-Ready Veri Mimarisi Nasıl Kurulmalı?
Kurumsal yapay zekâ dönüşümünde bütün veri altyapısını tek seferde yeniden tasarlamayı çoğu durumda doğru bir başlangıç olarak görmüyorum.
Bunun yerine somut iş kullanım senaryolarından hareket edilmesi gerektiğini düşünüyorum.
Örneğin bir şirket müşteri teklif hazırlama sürecinde AI ajanları kullanmak istiyorsa, öncelikle bu sürecin hangi verilere ihtiyaç duyduğu belirlenmelidir.
Müşteri bilgileri, ürün veya hizmet kataloğu, fiyatlandırma kuralları, geçmiş teklifler ve sözleşmesel koşullar gibi kaynaklar değerlendirilmelidir.
Daha sonra bu verilerin doğruluğu, güncelliği, erişilebilirliği ve iş bağlamı incelenmelidir.
Veri kalitesi sorunları tespit edildiğinde bunların iş sürecine etkisi değerlendirilmelidir.
Ardından uygun veri erişim yöntemleri, yetkilendirme kontrolleri ve izlenebilirlik mekanizmaları tasarlanmalıdır.
İlk uygulama kontrollü bir pilot olarak yürütülebilir.
Ancak pilotun başarısı yalnızca ajanın teknik olarak veri okuyabilmesiyle ölçülmemelidir.
Ajan doğru kaynağa erişiyor mu? Verileri doğru yorumluyor mu? Yetkisiz bilgiye ulaşması engelleniyor mu? Eksik veriyle karşılaştığında uygun davranıyor mu? Ortaya çıkan sonuçlar iş açısından doğrulanabiliyor mu?
Benim açımdan bu sorulara gerçek testlerle yanıt verilmeden sistemin kurumsal ölçekte yaygınlaştırılması önemli riskler oluşturabilir.
Bu nedenle AI-Ready veri mimarisinin aşamalı, risk temelli ve kullanım senaryolarına dayalı biçimde geliştirilmesi gerektiğine inanıyorum.
AI-Ready Veri Olgunluğu Nasıl Ölçülmeli?
AI-Ready veri mimarisinin başarısını yalnızca entegre edilen veri kaynağı sayısıyla değerlendirmeyi doğru bulmuyorum.
Çok sayıda veri kaynağının bir platforma bağlanması, AI ajanlarının güvenilir biçimde çalıştığını göstermez.
Bu nedenle veri olgunluğunun farklı boyutlarda değerlendirilmesi gerekir.
İlk boyut veri kalitesidir. Kritik veri alanları kullanım amaçlarına uygun doğruluk, bütünlük ve güncellik düzeyine sahip mi?
İkinci boyut anlamsal tutarlılıktır. Kurumsal kavramlar ve metrikler açık biçimde tanımlanmış mı?
Üçüncü boyut erişilebilirliktir. Ajanlar görevleri için gerekli verilere uygun yöntemlerle ulaşabiliyor mu?
Dördüncü boyut güvenlik ve yetkilendirmedir. Veri erişimleri görev ve risk bağlamına göre sınırlandırılıyor mu?
Beşinci boyut izlenebilirliktir. Kullanılan verilerin kaynakları ve önemli dönüşümleri değerlendirilebiliyor mu?
Altıncı boyut yönetişimdir. Kritik veri alanlarının sahipleri ve yönetim sorumlulukları belirlenmiş mi?
Yedinci boyut ise iş değeridir. Veri mimarisindeki iyileştirmeler, AI ajanlarının görev başarısını ve ilgili iş süreçlerinin performansını gerçekten geliştiriyor mu?
Bu boyutların değerlendirilmesi için kuruma özgü bir olgunluk modeli oluşturulabilir.
Ancak burada önemli bir sınır bulunuyor.
Bütün organizasyonlar için geçerli, tek bir AI-Ready veri olgunluk puanının bulunduğunu varsaymıyorum.
Olgunluk değerlendirmesinin ilgili sektör, iş süreçleri, risk profili ve yapay zekâ kullanım senaryolarına göre uyarlanması gerekir.
Benim açımdan olgunluk ölçümünün amacı bir puan üretmek değil, güvenilir AI operasyonlarını engelleyen veri mimarisi boşluklarını görünür hâle getirmektir.
Veri Mimarisi Yatırımları İş Değerine Nasıl Bağlanmalı?
Kurumsal dönüşüm çalışmalarında özellikle önemsediğim konulardan biri, teknoloji yatırımlarının iş sonuçlarıyla ilişkilendirilmesidir.
AI-Ready veri mimarisi de bu açıdan farklı değildir.
Veri katalogları, entegrasyon platformları, veri kalitesi araçları veya yeni depolama teknolojileri önemli teknik yetenekler sağlayabilir.
Ancak bunların kurulması tek başına iş değeri oluştuğunu göstermez.
Örneğin bir satış teklif sürecinde veri erişiminin iyileştirilmesi, teklif hazırlama süresini azaltabilir.
Bir satın alma sürecinde veri kalitesinin artırılması, hatalı siparişlerin azaltılmasına yardımcı olabilir.
Bir PMO uygulamasında veri bütünlüğünün geliştirilmesi, portföy analizlerinin güvenilirliğini artırabilir.
Ancak bu faydaların gerçekleştiği varsayılmamalıdır.
Öncelikle mevcut performans düzeyi ölçülmeli, ardından yapılan iyileştirmelerin etkisi uygun göstergelerle değerlendirilmelidir.
Benim açımdan AI-Ready veri mimarisine yapılacak yatırımların önceliği, teknik olarak en gelişmiş çözümü oluşturma hedefiyle değil; iş açısından en önemli veri sorunlarını çözme potansiyeliyle belirlenmelidir.
Bu yaklaşım, veri mimarisinin yalnızca maliyet oluşturan bir teknoloji programı olarak değil, ölçülebilir iş değeri üretmeyi hedefleyen bir dönüşüm yatırımı olarak yönetilmesini sağlayabilir.
AI Ajanlarının Güvenilir Veri Kullanımı İçin Yeni Bir Kontrol Katmanı
Geleceğin işletme modelinde AI ajanlarının farklı kurumsal sistemlerle etkileşim içinde çalışacağını düşünüyorum.
Bu nedenle veri mimarisinin yalnızca verileri depolayan ve paylaşan bir altyapı olarak değerlendirilmesi yeterli olmayacak.
Aynı zamanda verilerin hangi amaçlarla kullanılabileceğini, hangi koşullarda güvenilir kabul edileceğini ve hangi işlemler için ek doğrulama gerektiğini belirleyen kontrol mekanizmaları da önem kazanacak.
Örneğin bir AI ajanı belirli bir veri kaynağından bilgi aldığında, kaynağın güncelliği ve erişim yetkisi kontrol edilebilir.
Veriler arasında önemli tutarsızlık bulunduğunda sistem alternatif doğrulama sürecine geçebilir.
Yüksek etkili işlemlerde kullanılan kritik bilgiler için ek kontrol veya insan onayı gerekebilir.
Ancak bu kontrollerin tamamının büyük dil modeli tarafından gerçekleştirilmesini doğru bulmuyorum.
Özellikle güvenlik, yetkilendirme ve kritik veri doğrulama kurallarının uygun teknik bileşenler tarafından uygulanması gerekir.
Benim açımdan bu yaklaşım, AI ajanlarının esnek çalışma kapasitesini korurken kurumsal veri yönetişiminin temel ilkelerini de sürdürebilmeyi amaçlar.
Geleceğin İşletme Modelinde Veri Bir Kaynak Değil, Operasyonel Bir Yetkinliktir
Geleceğin işletme modelini değerlendirirken verinin yalnızca kararları destekleyen bir kaynak olmaktan daha geniş bir rol üstleneceğini düşünüyorum.
Çünkü AI ajanları, belirli görevleri gerçekleştirmek için sürekli olarak kurumsal bilgiye ihtiyaç duyacak.
Bu durum veri mimarisini, operasyonların nasıl çalıştığını belirleyen temel bileşenlerden biri hâline getirebilir.
Ancak verinin öneminin artması, bütün organizasyonların tek bir merkezi veri platformuna geçmesi gerektiği anlamına gelmez.
Benim açımdan önemli olan, farklı sistemlerde bulunan verilerin ortak güvenilirlik, anlam ve erişim ilkeleriyle kullanılabilmesidir.
Bu yaklaşımın organizasyon tasarımı açısından da sonuçları bulunuyor.
Veri sahipliği, süreç sahipliği ve AI ajanlarının operasyonel sorumlulukları birbirleriyle daha yakın ilişki içinde yönetilmek zorunda kalabilir.
Örneğin bir iş süreci sahibi, yalnızca sürecin performansından değil, süreçte kullanılan kritik verilerin uygunluğundan da sorumlu olabilir.
AI operasyonlarını yöneten ekipler ise ajanların görev başarısını değerlendirirken veri kalitesi ve erişim sorunlarını da dikkate almak zorunda kalabilir.
Bu nedenle geleceğin işletmelerinde veri yönetiminin yalnızca teknik uzmanlık alanı olarak değil, organizasyonel bir yetkinlik olarak gelişmesi gerektiğine inanıyorum.
Sonuç: Güvenilir AI Ajanları Güvenilir Veri Mimarisi Üzerinde Çalışır
Yapay zekâ ajanlarının kurumsal operasyonlarda daha fazla görev üstlenmesi, şirketler için önemli fırsatlar oluşturuyor.
Ancak bu fırsatların sürdürülebilir biçimde değerlendirilebilmesi, yalnızca daha gelişmiş modellerin kullanılmasına veya daha fazla ajanın devreye alınmasına bağlı değildir.
Ajanların eriştiği verilerin doğruluğu, güncelliği, anlamı, güvenliği ve izlenebilirliği de belirleyici olacaktır.
Bu nedenle AI-Ready veri mimarisini, kurumsal yapay zekâ dönüşümünün sonradan ele alınacak teknik bileşenlerinden biri olarak görmüyorum.
Benim açımdan veri mimarisi, dijital iş gücünün güvenilir biçimde çalışabilmesi için gerekli temel işletme yeteneklerinden biridir.
Ancak burada hedefin bütün kurumsal verileri tek bir platformda toplamak veya her veri kaynağını gerçek zamanlı hâle getirmek olduğunu düşünmüyorum.
Asıl hedef, AI ajanlarının görevlerini yerine getirmek için ihtiyaç duydukları doğru verilere, doğru bağlamda ve doğru yetkilerle ulaşabilmelerini sağlamaktır.
Bu hedefe ulaşmak için veri kalitesi, anlamsal tutarlılık, erişim yönetimi, veri sahipliği ve izlenebilirlik birlikte ele alınmalıdır.
Kurumsal dönüşüm perspektifimden baktığımda temel düşüncem şu:
Geleceğin işletmelerinde yapay zekâ ajanlarının değeri yalnızca sahip oldukları zekâ kapasitesiyle değil, güvenilir kurumsal bilgiye ne kadar doğru erişebildikleri ve bu bilgiyi ne kadar kontrollü kullanabildikleriyle belirlenecektir.
Bu nedenle AI-Ready veri mimarisinin geliştirilmesini yalnızca bir veri platformu modernizasyonu olarak değerlendirmiyorum.
Bu çalışma, organizasyonun kararlarını, iş süreçlerini ve dijital iş gücünü güvenilir bilgi üzerine inşa etmesini sağlayan stratejik bir dönüşüm alanıdır.
Çünkü geleceğin işletme modelini tasarlamak, yalnızca insanlarla AI ajanları arasında görev dağılımı yapmak değildir.
Aynı zamanda bu görevlerin hangi verilere dayanarak, hangi kontrollerle ve hangi iş hedefleri doğrultusunda gerçekleştirileceğini belirlemektir.
Ve bana göre yapay zekâ çağında kurumsal dönüşümün kalıcı değer üretmesi, büyük ölçüde bu veri temelinin ne kadar sağlam oluşturulduğuna bağlı olacaktır.
Bilgin Çavuş
Kurumsal Dönüşüm Stratejisti
Astrum Consulting Group — Kurucu ve Yönetici Ortak
bilgincavus.com


