Yapay zekâ yatırımlarını değerlendirirken şirketlerin giderek daha önemli bir soruyla karşı karşıya kaldığını düşünüyorum: Kurumlarımız yapay zekâyı ne kadar hızlı kullanabiliyor ve bu teknolojinin ürettiği değeri ne kadar artırabiliyor? Ancak benim açımdan bu sorunun yanında en az onun kadar önemli bir başka soru bulunuyor: Kullandığımız veriler, modeller ve yapay zekâ ajanları üzerinde gerçekte ne kadar kontrol sahibiyiz? Kurumsal dönüşüm, teknoloji yönetimi, proje yönetişimi ve iş geliştirme alanlarında edindiğim deneyimler, teknolojik bir çözümün devreye alınmasıyla onun kurumsal açıdan güvenilir, sürdürülebilir ve yönetilebilir hâle gelmesinin farklı başarı ölçütleri olduğunu gösteriyor. Bugün veri egemenliği, kişisel verilerin korunması ve yapay zekâ düzenlemelerine uyum konularını yalnızca hukuk veya bilgi güvenliği ekiplerinin sorumluluğuna bırakmanın yeterli olmadığını düşünüyorum. Çünkü bu konular doğrudan şirketin teknoloji mimarisini, tedarikçi seçimlerini, operasyon modelini, karar yetkilerini ve gelecekteki rekabet kapasitesini etkiliyor.
Yapay Zekâ Çağında Veri Egemenliği Neden Stratejik Bir Konuya Dönüştü?
Kurumsal teknoloji yönetiminde veri güvenliği uzun zamandır önemli bir gündem maddesi. Ancak yapay zekâ sistemlerinin yaygınlaşmasıyla birlikte veri üzerindeki kontrol meselesinin kapsamı genişliyor.
Geleneksel bilgi sistemlerinde temel sorular çoğunlukla verinin nerede saklandığı, kimlerin erişebildiği, nasıl korunduğu ve hangi amaçlarla işlendiği üzerinde yoğunlaşıyordu. Bu sorular bugün de önemini koruyor. Fakat üretken yapay zekâ ve ajan tabanlı sistemler, veri kullanımının sınırlarını daha karmaşık hâle getiriyor.
Bir çalışan kurumsal bir belgeyi yapay zekâ uygulamasına yüklediğinde, bir AI ajanı CRM kayıtlarını analiz ettiğinde veya bir dil modeli şirketin finansal verileri üzerinden öneriler ürettiğinde, yalnızca veri erişimi gerçekleşmiyor. Aynı zamanda verinin hangi sistemler tarafından işlendiği, hangi sağlayıcılarla paylaşıldığı, ne kadar süreyle saklandığı, hangi çıktılara dönüştürüldüğü ve sonraki işlemleri nasıl etkilediği gibi yeni sorular ortaya çıkıyor.
Bu nedenle veri egemenliğini yalnızca verinin belirli bir ülkede saklanması olarak tanımlamayı yeterli bulmuyorum.
Benim yaklaşımımda veri egemenliği, bir kurumun verilerinin kullanım amaçları, erişim koşulları, işleme ortamları, paylaşımı, saklanması, taşınabilirliği ve yaşam döngüsü üzerinde hukuken ve operasyonel olarak etkili kontrol kurabilmesidir.
Burada veri yerleşimi ile veri egemenliği arasındaki ayrım önemlidir. Bir verinin Türkiye'deki bir veri merkezinde saklanması, tek başına bütün erişimlerin Türkiye'den gerçekleştiğini veya verinin yabancı bir hizmet sağlayıcının kontrolünden tamamen bağımsız olduğunu göstermez. Benzer şekilde yurt dışında barındırılan her veri işleme faaliyetinin otomatik olarak hukuka aykırı olduğunu söylemek de doğru değildir.
Asıl değerlendirilmesi gereken, verinin hangi hukuki çerçevede, hangi taraflarca, hangi teknik ve sözleşmesel kontroller altında işlendiğidir.
Bana göre geleceğin işletme modelinde veri egemenliği, altyapı seçiminden daha geniş bir kurumsal mimari kararıdır.
KVKK ile AB Yapay Zekâ Yasası Aynı Sorunu mu Düzenliyor?
Şirketlerin en sık karşılaşabileceği kavramsal karışıklıklardan biri, kişisel verilerin korunması düzenlemeleriyle yapay zekâ düzenlemelerini aynı uyum alanı olarak değerlendirmektir.
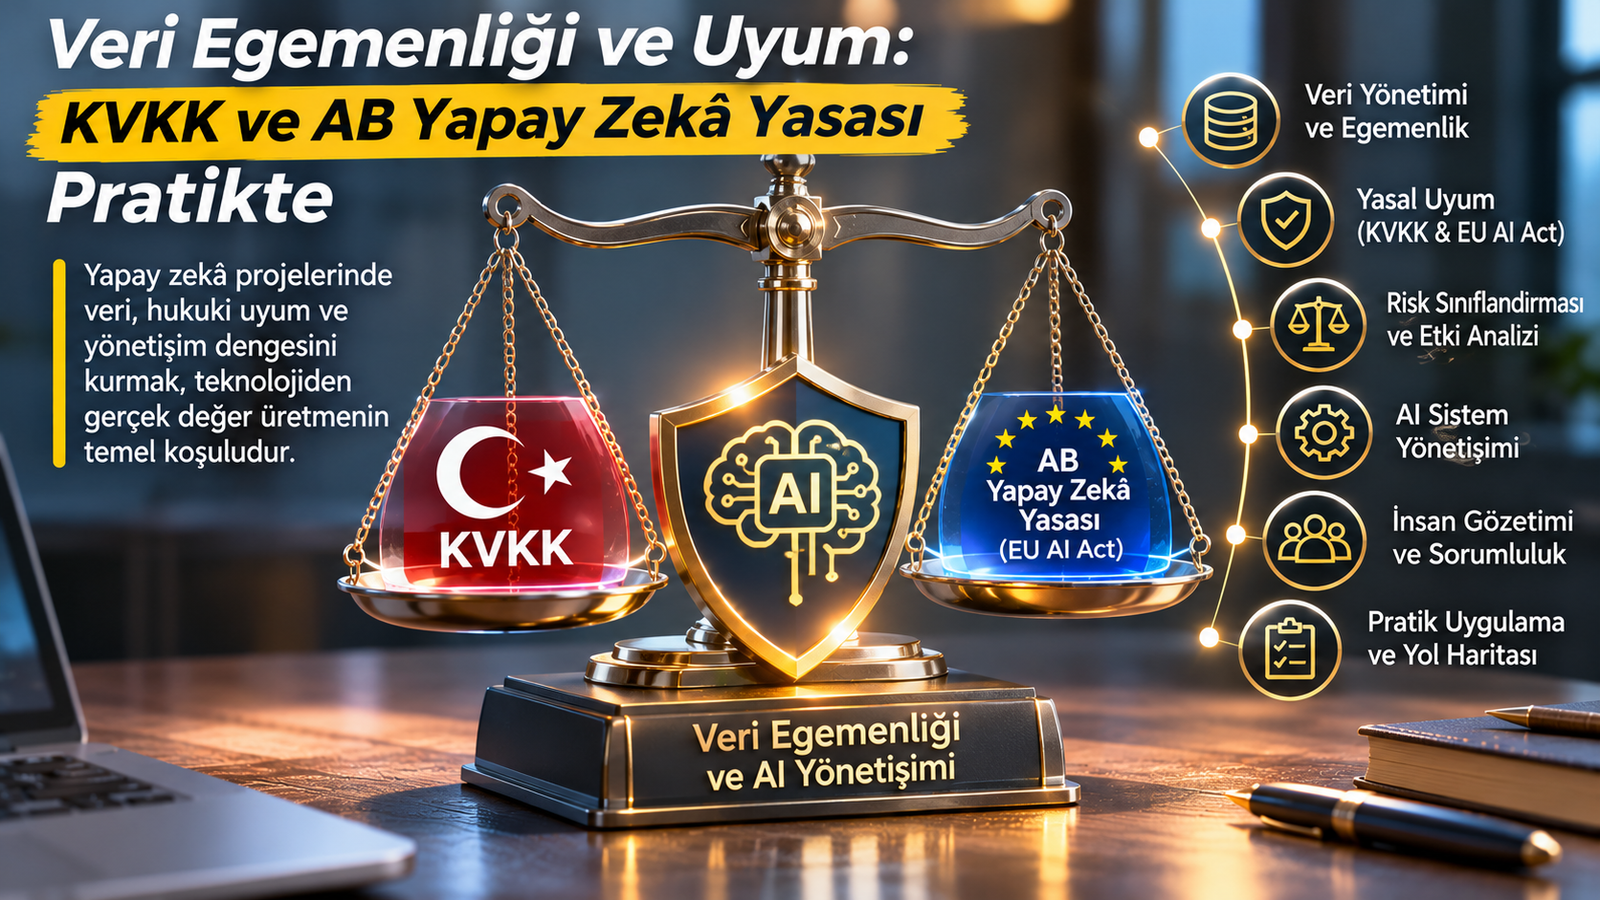
Oysa Türkiye'deki 6698 sayılı Kişisel Verilerin Korunması Kanunu (KVKK) ile Avrupa Birliği Yapay Zekâ Yasası (EU AI Act) farklı düzenleme amaçlarına ve yükümlülük yapılarına sahiptir.
KVKK'nın temel konusu, kişisel verilerin işlenmesinde bireylerin temel hak ve özgürlüklerinin korunması ve veri işleyen gerçek ve tüzel kişilerin yükümlülüklerinin düzenlenmesidir.
AB Yapay Zekâ Yasası ise belirli yapay zekâ sistemleri ve genel amaçlı yapay zekâ modelleri bakımından risk temelli bir düzenleyici çerçeve oluşturur. Düzenleme, bazı yapay zekâ uygulamalarını yasaklarken, yüksek riskli sistemlere özel yükümlülükler getirir ve belirli sistemler için şeffaflık kuralları öngörür.
Dolayısıyla kişisel veri içermeyen bir yapay zekâ sistemi de AB Yapay Zekâ Yasası kapsamındaki yükümlülüklerle karşılaşabilir. Buna karşılık kişisel veri işleyen ancak AI Act bakımından yüksek riskli sınıfa girmeyen bir uygulamanın da KVKK veya ilgili diğer veri koruma düzenlemelerine uyması gerekir.
Örneğin çalışanların özlük verilerini işleyen bir insan kaynakları sistemi, yapay zekâ kullanmasa bile kişisel veri koruma yükümlülüklerine tabidir.
Buna karşılık çalışan adaylarını değerlendirmek veya işe alım kararlarını desteklemek amacıyla kullanılan belirli bir yapay zekâ sistemi, kişisel veri koruma yükümlülüklerinin yanında AB Yapay Zekâ Yasası'nın yüksek riskli sistemlere ilişkin hükümleriyle de ilişkili olabilir.
Ancak her insan kaynakları yazılımının otomatik olarak aynı risk kategorisine girdiği söylenemez. Sistemin amaçlanan kullanımı, işlevi, ilgili istisnalar ve düzenlemenin uygulanabilir hükümleri birlikte değerlendirilmelidir.
Benim açımdan temel yönetim ilkesi şudur: Kişisel verilerin korunmasına uyum ile yapay zekâ yönetişimi birbirini tamamlar, ancak birbirinin yerine geçmez.
Türk Şirketleri AB Yapay Zekâ Yasası'nı Neden Dikkate Almalı?
AB Yapay Zekâ Yasası'nın yalnızca Avrupa Birliği sınırları içerisinde kurulmuş şirketleri ilgilendirdiği düşüncesi eksik bir değerlendirmedir.
Düzenleme, belirli koşullarda AB dışındaki sağlayıcılara ve yapay zekâ sistemlerini kullanan kuruluşlara da uygulanabilir.
Örneğin Türkiye'de geliştirilen bir yapay zekâ sisteminin AB pazarına sunulması veya AB'de kullanıma alınması, sistemin rolüne ve kullanımına bağlı olarak düzenleme kapsamına girebilir. Ayrıca bazı durumlarda AB dışında kurulu sağlayıcı veya kullanıcıların sistem çıktılarının AB'de kullanılması da kapsam açısından önem taşır.
Bu nedenle Türkiye'deki bir teknoloji şirketinin, danışmanlık kuruluşunun veya yazılım sağlayıcısının yalnızca Türkiye'de kurulmuş olması, AB Yapay Zekâ Yasası'nın hiçbir zaman uygulanmayacağı anlamına gelmez.
Ancak burada başka bir yanılgıdan da kaçınmak gerekir.
AB ile ticaret yapan her Türk şirketinin bütün yapay zekâ uygulamalarının otomatik olarak yüksek riskli sayılması veya düzenlemedeki bütün yükümlülüklere tabi olması söz konusu değildir.
Öncelikle şirketin düzenleme bakımından hangi rolü üstlendiği belirlenmelidir.
Bir şirket yapay zekâ sisteminin sağlayıcısı olabilir, sistemi kendi faaliyetlerinde kullanan bir kuruluş olabilir, ithalatçı veya dağıtıcı olarak hareket edebilir. Bazı projelerde birden fazla rolün veya farklı taraflara ait yükümlülüklerin değerlendirilmesi gerekebilir.
Bu rollerin birbirinden ayrılması, uyum programının doğru tasarlanması açısından önemlidir.
Benim önerim, AB ile ticari ilişkisi bulunan veya Avrupa pazarına yapay zekâ tabanlı ürün ve hizmet sunmayı planlayan şirketlerin, yapay zekâ uygulamalarını yalnızca teknik mimari açısından değil, pazar erişimi ve düzenleyici kapsam açısından da değerlendirmeleridir.
Çünkü gelecekte bir ürünün teknik olarak çalışması, o ürünün hedef pazarda hukuken kullanılabilir olduğu anlamına gelmeyebilir.
AB Yapay Zekâ Yasası'nın Risk Temelli Yaklaşımı
AB Yapay Zekâ Yasası'nın kurumsal yönetim açısından önemli özelliklerinden biri, bütün yapay zekâ uygulamalarına aynı yükümlülükleri getirmemesidir.
Düzenleme, belirli uygulamaları yasaklanan yapay zekâ uygulamaları kapsamında ele alırken, yüksek riskli sistemler için daha kapsamlı gereklilikler öngörür. Bunun yanında belirli şeffaflık yükümlülükleri ve genel amaçlı yapay zekâ modellerine ilişkin ayrı hükümler bulunur.
Bu yaklaşımın işletmeler açısından önemli bir sonucu vardır.
Bir şirketin yapay zekâ envanterindeki bütün uygulamalarını aynı kontrol seviyesinde yönetmesi her zaman gerekli veya verimli olmayabilir.
Örneğin kurumsal bir toplantı notunun özetlenmesi amacıyla kullanılan yardımcı bir uygulama ile çalışanların işe alınmasını etkileyen bir karar destek sistemi aynı risk profilini taşımayabilir.
Benzer şekilde bir pazarlama metni taslağı hazırlayan sistem ile kritik altyapıların yönetiminde kullanılan belirli bir yapay zekâ uygulamasının operasyonel etkileri farklıdır.
Ancak risk sınıflandırmasının yalnızca uygulamanın adından hareketle yapılmaması gerekir.
Sistemin kullanım amacı, gerçek işlevi, karar üzerindeki etkisi, kullanıcıları, işlediği veriler ve uygulanabilir mevzuat hükümleri birlikte incelenmelidir.
Ayrıca şirketin kendi iç risk sınıflandırmasıyla AB Yapay Zekâ Yasası'ndaki hukuki sınıflandırmanın aynı şey olmadığını vurgulamak istiyorum.
Bir şirket belirli bir uygulamayı kendi operasyonları açısından kritik kabul edebilir. Ancak bu değerlendirme, uygulamanın otomatik olarak AI Act kapsamında yüksek riskli sistem olduğu anlamına gelmez.
Bana göre doğru yaklaşım, hukuki sınıflandırmayı kurumsal operasyonel risk değerlendirmesiyle birlikte, ancak birbirine karıştırmadan yürütmektir.
Düzenlemelerin Takvimi Neden Sürekli İzlenmeli?
AB Yapay Zekâ Yasası 1 Ağustos 2024 tarihinde yürürlüğe girdi ve hükümleri kademeli bir uygulama takvimine bağlandı.
İlk takvimde yasaklanan bazı uygulamalara ve yapay zekâ okuryazarlığına ilişkin hükümler 2 Şubat 2025'ten, genel amaçlı yapay zekâ modellerine ilişkin belirli hükümler ise 2 Ağustos 2025'ten itibaren uygulanmaya başladı. Diğer hükümler için 2026 ve sonrasına uzanan farklı tarihler öngörüldü.
Ancak yapay zekâ düzenlemeleri gelişen bir alan olduğu için şirketlerin yalnızca düzenlemenin ilk yayımlandığı tarihteki takvime dayanarak uyum planı hazırlamasını doğru bulmuyorum.
AB düzeyindeki mevzuat değişiklikleri, uygulama rehberleri, teknik standartlar ve geçiş düzenlemeleri izlenmelidir. Özellikle yüksek riskli sistemlerin yükümlülüklerinin uygulanma tarihleri bakımından güncel resmî metinlerin kontrol edilmesi gerekir.
Benim açımdan uyum yönetimi, bir defa mevzuat incelemesi yapıp kontrol listesi oluşturmak değildir.
Mevzuat değişikliklerini takip eden, değişikliklerin ürün ve operasyon mimarisine etkisini değerlendiren ve gerekli aksiyonları yöneten sürekli bir kurumsal yetenektir.
Bu nedenle yapay zekâ uyum programlarının statik belgeler yerine yaşayan bir yönetişim sistemi olarak tasarlanması gerektiğine inanıyorum.
KVKK Açısından Yapay Zekâ Kullanımında İlk Soru: Hangi Veriyi, Neden İşliyoruz?
Yapay zekâ projelerinde sıklıkla teknoloji seçiminden başlandığını görüyorum. Hangi modelin kullanılacağı, hangi platformun tercih edileceği, hangi entegrasyonların yapılacağı veya kaç AI ajanının geliştirileceği ilk tartışılan konular arasında yer alabiliyor.
Oysa kişisel veri içeren bir kullanım senaryosunda benim ilk sorum farklıdır.
Bu sistem hangi kişisel verileri, hangi belirli amaçlarla ve hangi hukuki işleme şartına dayanarak kullanacak?
Çünkü bir yapay zekâ modelinin belirli verilere teknik olarak erişebilmesi, bu verilere hukuken erişebileceği anlamına gelmez.
Örneğin müşteri ilişkileri yönetimi sistemindeki verilerin bir yapay zekâ uygulaması tarafından analiz edilmesi planlanıyorsa, öncelikle verilerin hangi amaçlarla toplandığı ve yeni kullanımın mevcut işleme amaçlarıyla ilişkisi değerlendirilmelidir.
Ayrıca kişisel veri işleme faaliyetinin uygun bir hukuki sebebe dayanması gerekir.
Burada açık rızanın her veri işleme faaliyeti için zorunlu olduğu yönündeki yaygın varsayımı doğru bulmuyorum. KVKK'nın 5. maddesinde açık rıza dışında da belirli işleme şartları düzenlenmiştir. Özel nitelikli kişisel veriler bakımından ise 6. maddede yer alan ayrı şartların değerlendirilmesi gerekir.
Önemli olan, somut işleme faaliyeti için gerçekten uygulanabilir hukuki şartın belirlenmesidir.
Bunun yanında veri minimizasyonu, amaçla bağlantılılık, sınırlılık, ölçülülük ve gerekli saklama süresi gibi ilkeler de dikkate alınmalıdır.
Benim yaklaşımımda veri yönetişimi, yapay zekâ projesinin sonunda hukuk ekibine gönderilen bir onay dokümanı değildir.
Kullanım senaryosu tasarlanırken başlayan bir mimari ve yönetim disiplinidir.
Bulut Yapay Zekâ Kullanmak KVKK'ya Aykırı mı?
Bu soruya tek kelimelik bir cevap verilmesini doğru bulmuyorum.
Bulut teknolojilerinin kullanılması kendi başına KVKK'ya aykırılık oluşturmaz. Ancak kişisel verilerin hangi ülkelerde, hangi taraflar tarafından ve hangi hukuki mekanizmalarla işlendiği değerlendirilmelidir.
Özellikle yurt dışına kişisel veri aktarımı söz konusu olduğunda KVKK'nın 9. maddesindeki şartlar önem kazanır.
Türkiye'de 2024 yılında yapılan değişikliklerle yurt dışına kişisel veri aktarımına ilişkin hukuki çerçeve önemli ölçüde yeniden düzenlendi.
Yeni yapı, ilgili koşullarda yeterlilik kararları, uygun güvenceler ve istisnai hâllere ilişkin mekanizmalar içerir. Uygun güvence mekanizmaları arasında Kurul tarafından ilan edilen standart sözleşmeler de bulunmaktadır.
Ancak standart sözleşmenin varlığının her türlü veri aktarımını koşulsuz olarak hukuka uygun hâle getirdiği düşünülmemelidir. Aktarımın dayanağı, tarafların rolleri, uygulanabilir şartlar ve diğer yükümlülükler birlikte incelenmelidir.
Ayrıca standart sözleşmelerin imzalanmasından sonra Kuruma bildirim yükümlülüğü ve ilgili süreler de dikkate alınmalıdır.
Benim açımdan bir bulut yapay zekâ hizmeti seçilirken yalnızca veri merkezinin konumuna bakmak yeterli değildir.
Hizmet sağlayıcının alt işleyenleri, veri saklama politikaları, günlük kayıtları, destek erişimleri, verilerin model eğitimi için kullanılıp kullanılmadığı, silme mekanizmaları ve sözleşmesel yükümlülükleri de değerlendirilmelidir.
Özellikle kurumsal yapay zekâ kullanımında, kullanıcıların gönderdiği girdilerin ve sistem çıktılarının nasıl işlendiği açık biçimde anlaşılmalıdır.
Çünkü bir hizmetin kurumsal abonelik olarak satın alınması, bütün veri koruma gerekliliklerinin kendiliğinden karşılandığı anlamına gelmez.
Veri Egemenliği ile Teknolojik Bağımsızlık Arasındaki İlişki
Veri egemenliği konusunu teknoloji bağımsızlığından tamamen ayrı değerlendirmiyorum.
Bir şirketin bütün kritik yapay zekâ yetkinliklerini tek bir sağlayıcının özel servislerine bağlaması, başlangıçta önemli hız ve kullanım kolaylığı sağlayabilir.
Ancak zaman içerisinde model değiştirme, verileri taşıma, farklı altyapılara geçme veya belirli hizmetleri kurum içinde çalıştırma ihtiyacı ortaya çıktığında mimari bağımlılıklar önemli hâle gelebilir.
Burada bütün şirketlerin açık kaynak modeller kullanması veya yapay zekâ altyapısını kendi veri merkezlerinde kurması gerektiğini savunmuyorum.
Böyle bir yaklaşımın yatırım maliyeti, operasyonel karmaşıklığı, güvenlik sorumluluğu ve uzmanlık gereksinimleri bulunmaktadır.
Benim için doğru soru, hangi teknolojinin ideolojik olarak daha bağımsız olduğu değildir.
Şirketin ihtiyaç duyduğu kontrol düzeyinin hangi mimariyle, hangi maliyet ve risk koşullarında sağlanabileceğidir.
Bazı kullanım senaryolarında yönetilen bulut hizmetleri uygun olabilir. Bazılarında özel bulut, kurum içi model çalıştırma veya hibrit mimariler daha anlamlı seçenekler oluşturabilir.
Özellikle hassas verilerin işlendiği ve operasyonel sürekliliğin kritik olduğu alanlarda alternatif sağlayıcı stratejisi, veri taşınabilirliği ve çıkış planlarının önceden değerlendirilmesini önemli buluyorum.
Bana göre teknoloji egemenliği, bütün teknolojilere sahip olmak değil, kritik teknolojik kararları gerektiğinde değiştirebilme kapasitesini korumaktır.
AI Ajanları Veri Egemenliği Sorununu Nasıl Değiştiriyor?
Yapay zekâ ajanlarının kurumsal sistemlerde daha fazla görev üstlenmesi, veri egemenliği ve uyum yönetimini yeni bir düzeye taşıyor.
Çünkü geleneksel bir yapay zekâ uygulaması belirli bir soruya yanıt üretirken, ajan tabanlı bir sistem farklı veri kaynaklarına erişebilir, araç çağrıları gerçekleştirebilir, başka sistemlere bilgi aktarabilir ve yetkilendirildiği ölçüde işlemler başlatabilir.
Örneğin bir satış ajanı CRM verilerini analiz edebilir, ERP sisteminden stok bilgisi alabilir, teklif taslağı oluşturabilir ve belirli koşullarda müşteriye gönderilmek üzere bir işlem hazırlayabilir.
Bu iş akışında kişisel veriler, ticari sırlar ve operasyonel bilgiler birden fazla sistem arasında hareket edebilir.
Benim açımdan bu nedenle AI ajanlarının veri erişimi yalnızca genel bir kullanıcı yetkisiyle yönetilmemelidir.
Ajanın hangi veri kategorilerine erişebileceği, hangi araçları kullanabileceği, hangi işlemleri gerçekleştirebileceği ve hangi durumlarda insan onayına ihtiyaç duyacağı açık biçimde tanımlanmalıdır.
Özellikle bir ajan tarafından kullanılan bilginin başka bir modele, harici API'ye veya üçüncü taraf hizmete aktarılması, veri işleme zincirinin kapsamını değiştirebilir.
Bu nedenle ajan mimarisinde veri akışlarının görünür olması gerekir.
Bir başka önemli konu da ajanların işlem kayıtlarıdır.
Hangi veriye ne zaman erişildiği, hangi araçların çağrıldığı, hangi kararın hangi girdilere dayandığı ve hangi işlemlerin gerçekleştirildiği uygun kapsamda izlenebilmelidir.
Ancak izlenebilirlik amacıyla sınırsız veri kaydı tutulmasını da doğru bulmuyorum. Denetim kayıtlarının kendileri kişisel veri veya hassas kurumsal bilgi içerebilir.
Dolayısıyla kayıtların kapsamı, erişim yetkileri, saklama süreleri ve güvenliği de tasarımın parçası olmalıdır.
Benim yaklaşımımda AI ajanları için veri egemenliği, erişim kontrolüyle başlayıp işlem yetkisi, veri akışı, insan gözetimi ve denetlenebilirliğe uzanan bütünleşik bir yönetişim konusudur.
İnsan Gözetimi: Her Kararı İnsan mı Onaylamalı?
Yapay zekâ düzenlemeleri ve kurumsal risk yönetimi tartışmalarında insan gözetimi önemli bir yer tutuyor.
Ancak insan gözetimini her yapay zekâ çıktısının bir çalışan tarafından onaylanması olarak yorumlamayı doğru bulmuyorum.
Böyle bir yaklaşım hem operasyonel verimliliği azaltabilir hem de onay mekanizmalarını biçimsel hâle getirebilir.
Benim açımdan insan gözetimi, riskle orantılı ve gerçekten etkili olacak biçimde tasarlanmalıdır.
Örneğin kurum içi bir bilgi tabanında doküman arayan yardımcı uygulamanın her arama sonucu için yönetici onayı gerektirmesi anlamlı olmayabilir.
Buna karşılık çalışanların haklarını, müşterilerin finansal durumunu veya kritik operasyonel süreçleri etkileyen belirli kararlar için daha güçlü insan değerlendirmesi gerekebilir.
Ancak bu ayrım yalnızca kurumun tercihine bırakılmamalıdır. Uygulanabilir mevzuatın öngördüğü özel yükümlülükler ve karar türüne ilişkin hukuki sınırlar dikkate alınmalıdır.
Özellikle AB Yapay Zekâ Yasası'nın yüksek riskli sistemler için düzenlediği insan gözetimi gereklilikleri ile GDPR veya KVKK kapsamında gündeme gelebilecek otomatik karar verme ve ilgili kişi hakları ayrı ayrı incelenmelidir.
Benim yaklaşımımda etkili insan gözetimi için üç koşul önemlidir.
İlk olarak insanın kararın anlamını değerlendirebilecek bilgiye sahip olması gerekir.
İkinci olarak gerektiğinde yapay zekâ önerisini reddetme, düzeltme veya işlemi durdurma yetkisi bulunmalıdır.
Üçüncü olarak gözetim mekanizmasının operasyonel olarak uygulanabilir olması gerekir.
Yalnızca ekranda bir onay düğmesinin bulunması, etkili insan gözetiminin oluşturulduğunu kanıtlamaz.
Bu nedenle insan gözetimini bir kullanıcı arayüzü özelliği değil, karar sorumluluğunun tasarımına ilişkin bir yönetim ilkesi olarak değerlendiriyorum.
Yapay Zekâ Uyumunda Sorumluluk Kime Ait?
Kurumsal yapay zekâ projelerinde sorumlulukların belirsiz kalması önemli risklerden biridir.
Teknoloji ekibi modelin teknik performansını izleyebilir. Hukuk ekibi sözleşmeleri ve mevzuat yükümlülüklerini değerlendirebilir. Bilgi güvenliği ekibi erişim ve güvenlik kontrollerini yönetebilir. İş birimi ise yapay zekâ sisteminin operasyonel sonuçlarından sorumlu olabilir.
Ancak bu faaliyetler arasında açık bir sorumluluk mimarisi bulunmadığında, önemli kararlar birimler arasında sahipsiz kalabilir.
Benim yaklaşımımda kurumsal yapay zekâ yönetişimi, merkezi politika ve kontrol mekanizmalarıyla iş birimlerinin operasyonel sorumluluklarını birleştirmelidir.
Örneğin yapay zekâ kullanımına ilişkin ortak güvenlik standartları merkezi olarak tanımlanabilir. Kişisel veri işleme faaliyetleri için hukuki değerlendirme ve veri koruma süreçleri yürütülebilir. Model performansı ve teknik riskler ilgili teknoloji ekipleri tarafından izlenebilir.
Ancak bir yapay zekâ uygulamasının hangi iş amacıyla kullanılacağı ve hangi sonuçları üretmesi gerektiği ilgili iş birimi tarafından sahiplenilmelidir.
Burada önemli olan, yapay zekâ uygulamasının sahibi ile veri sorumlusunun hukuki anlamda her zaman aynı kişi veya birim olmayabileceğini anlamaktır.
KVKK kapsamındaki veri sorumlusu ve veri işleyen rolleri, fiilî veri işleme ilişkileri ve mevzuattaki tanımlar üzerinden değerlendirilmelidir.
Benzer şekilde AB Yapay Zekâ Yasası kapsamındaki sağlayıcı ve kullanıcı kuruluş rolleri de sözleşmelerde kullanılan ticari unvanlardan bağımsız olarak hukuki tanımlar çerçevesinde belirlenmelidir.
Bana göre etkili yönetişim, bütün sorumlulukların tek bir komiteye verilmesi değildir.
Her kararın sahibinin, kontrol mekanizmasının ve hesap verebilirlik ilişkisinin açık olmasıdır.
Kurumsal Yapay Zekâ Envanteri Neden İlk Adımlardan Biri Olmalı?
Bir şirketin hangi yapay zekâ sistemlerini kullandığını tam olarak bilmeden kapsamlı bir uyum programı yürütmesi zor olacaktır.
Özellikle çalışanların bağımsız olarak edindiği üretken yapay zekâ araçları, departmanların kullandığı SaaS çözümleri ve kurumsal sistemlere gömülü yapay zekâ özellikleri envanterin kapsamını karmaşıklaştırabilir.
Bu nedenle yapay zekâ yönetişiminde sistematik bir envanter yaklaşımını önemli buluyorum.
Ancak envanteri yalnızca uygulama adlarının bulunduğu bir liste olarak düşünmüyorum.
Her kullanım senaryosu için iş amacı, süreç sahibi, teknik sağlayıcı, kullanılan model veya hizmet, veri kategorileri, veri akışları, kullanıcı grupları, karar etkisi, risk değerlendirmesi ve uygulanabilir kontrol gereksinimleri görünür olmalıdır.
Örneğin bir müşteri hizmetleri yapay zekâ uygulaması için yalnızca hangi modelin kullanıldığını bilmek yeterli değildir.
Sistemin müşteri verilerine erişip erişmediği, konuşmaları kaydedip kaydetmediği, verileri üçüncü taraflarla paylaşıp paylaşmadığı, müşteriye doğrudan yanıt verip vermediği ve gerektiğinde insan temsilciye devretme mekanizmasının bulunup bulunmadığı da önemlidir.
Bu bilgiler, hem veri koruma hem de yapay zekâ yönetişimi açısından gerekli değerlendirmelerin yapılmasını kolaylaştırır.
Bana göre yapay zekâ envanteri, bir defa hazırlanıp arşivlenen belge olmamalıdır.
Yeni uygulamalar devreye alındığında, modeller değiştirildiğinde veya veri akışları genişletildiğinde güncellenen yaşayan bir kontrol mekanizması olmalıdır.
Yapay Zekâ Tedarikçisi Seçerken Hangi Sorular Sorulmalı?
Yapay zekâ tedarikçi değerlendirmesinin yalnızca teknik yetenek, lisans maliyeti ve kullanım kolaylığı üzerinden yürütülmesini yeterli bulmuyorum.
Özellikle kurumsal verilerle çalışan sistemlerde sağlayıcının veri işleme modeli ve sözleşmesel yükümlülükleri önemli hâle gelir.
Örneğin hizmet sağlayıcının müşteri verilerini hangi amaçlarla işlediği, girdileri veya çıktıları model geliştirme amacıyla kullanıp kullanmadığı, hangi alt hizmet sağlayıcılarla çalıştığı ve veri silme taleplerini nasıl karşıladığı anlaşılmalıdır.
Bunun yanında güvenlik sertifikalarının bulunması, tek başına bütün hukuki gerekliliklerin karşılandığını göstermez.
ISO/IEC 27001 gibi standartlar bilgi güvenliği yönetimi açısından önemli referanslar sunabilir. ISO/IEC 42001 ise yapay zekâ yönetim sistemlerinin kurulması için bir çerçeve sağlar.
Ancak bu standartlara uygunluk veya sertifikasyon, KVKK ya da AB Yapay Zekâ Yasası kapsamındaki bütün yükümlülüklerin otomatik olarak yerine getirildiği anlamına gelmez.
Benim açımdan tedarikçi değerlendirmesinde teknik güvenlik, veri koruma, sözleşmesel kontrol, operasyonel süreklilik ve çıkış stratejisi birlikte ele alınmalıdır.
Özellikle kritik iş süreçlerinde kullanılan yapay zekâ sistemlerinin sağlayıcı değişikliği durumunda nasıl sürdürüleceği değerlendirilmelidir.
Çünkü bir tedarikçiye bağımlılık yalnızca maliyet meselesi değildir.
Veri taşınabilirliği, model davranışı, entegrasyon mimarisi ve operasyonel süreklilik üzerinde de etkiler oluşturabilir.
Uyum Programı Bir Kontrol Listesine İndirgenebilir mi?
Mevzuata uyum çalışmalarında kontrol listeleri önemli araçlardır. Ancak yapay zekâ yönetişiminin yalnızca belgelerin hazırlanması ve belirli kontrollerin işaretlenmesiyle tamamlandığını düşünmüyorum.
Çünkü yapay zekâ sistemleri zaman içerisinde değişebilir.
Model sürümleri güncellenebilir, yeni veri kaynakları eklenebilir, kullanım amacı genişletilebilir veya sistemin karar süreçlerindeki rolü farklılaşabilir.
Başlangıçta sınırlı kapsamda kullanılan bir yapay zekâ uygulaması, zaman içerisinde daha kritik operasyonel faaliyetlere entegre edilebilir.
Bu durumda ilk değerlendirmede uygun görülen kontrol mekanizmaları yetersiz kalabilir.
Benim yaklaşımımda uyum yönetimi, sistemin bütün yaşam döngüsünü kapsamalıdır.
Tasarım aşamasında kullanım amacı ve riskler değerlendirilmelidir. Geliştirme aşamasında veri akışları ve güvenlik kontrolleri doğrulanmalıdır. Canlıya geçiş öncesinde gerekli testler ve onaylar tamamlanmalıdır. Üretim ortamında performans, olaylar ve değişiklikler izlenmelidir.
Sistem önemli ölçüde değiştiğinde ilgili risk ve uyum değerlendirmeleri yeniden yapılmalıdır.
Burada amaç bütün yapay zekâ uygulamalarına aynı yoğunlukta bürokratik süreçler uygulamak değildir.
Riskle orantılı, uygulanabilir ve kanıt üretilebilen bir kontrol mimarisi oluşturmaktır.
Bana göre iyi tasarlanmış bir uyum programı, inovasyonu gereksiz yere yavaşlatmak yerine hangi sınırlar içerisinde güvenle ilerlenebileceğini açık hâle getirmelidir.
Veri Egemenliği ve Yapay Zekâ Uyumunu Operasyon Modeline Nasıl Entegre Ederiz?
Kurumsal dönüşüm perspektifimden baktığımda veri egemenliği ve yapay zekâ uyumunun ayrı bir proje olarak yürütülüp tamamlanmasını yeterli bulmuyorum.
Bu konuların işletme modelinin kalıcı bileşenleri hâline gelmesi gerektiğine inanıyorum.
Öncelikle şirketin veri mimarisinde hangi veri kategorilerinin kritik olduğu, hangi iş süreçlerinde kullanıldığı ve hangi sistemler arasında hareket ettiği anlaşılmalıdır.
Ardından yapay zekâ kullanım senaryoları bu veri mimarisiyle ilişkilendirilmelidir.
Bir yapay zekâ uygulamasının yalnızca teknik olarak hangi sistemlere bağlandığı değil, hangi verileri hangi amaçla kullandığı ve hangi kararları etkilediği de görünür olmalıdır.
Bunun yanında merkezi yapay zekâ politikaları, veri koruma süreçleri, tedarikçi değerlendirme mekanizmaları ve güvenlik standartları arasında tutarlılık sağlanmalıdır.
Örneğin bir iş biriminin yeni bir yapay zekâ hizmeti satın almak istemesi durumunda, bu talebin yalnızca satın alma onayından geçmesi yeterli olmayabilir.
Kullanım senaryosunun niteliğine göre veri koruma, bilgi güvenliği, teknoloji mimarisi ve yapay zekâ risk değerlendirmelerinin yapılması gerekebilir.
Ancak bu değerlendirmelerin birbirinden bağımsız ve tekrarlayan bürokratik süreçlere dönüşmesini de doğru bulmuyorum.
Benim önerim, şirketin mevcut satın alma, teknoloji değişikliği, bilgi güvenliği ve proje yönetişimi süreçleriyle entegre çalışan bir yapay zekâ değerlendirme mekanizması oluşturmasıdır.
Böylece uyum yönetimi, teknoloji yatırımlarının sonunda ortaya çıkan bir engel olmaktan çıkar.
Yatırım kararlarının kalitesini geliştiren bir kurumsal yeteneğe dönüşebilir.
İlk 90 Günde Uygulanabilir Bir Veri Egemenliği ve AI Uyum Programı
Veri egemenliği ve yapay zekâ uyumu konusunda bütün sorunların 90 gün içerisinde çözülebileceğini düşünmüyorum.
Özellikle çok sayıda sistem, farklı ülkelerde faaliyet gösteren şirketler ve karmaşık tedarikçi ilişkileri söz konusu olduğunda kapsamlı bir dönüşüm gerekebilir.
Ancak ilk 90 gün, mevcut durumun görünür hâle getirilmesi ve öncelikli kontrol mekanizmalarının oluşturulması için anlamlı bir başlangıç olabilir.
İlk 30 günde şirketin kullandığı yapay zekâ sistemleri ve öncelikli kullanım senaryoları belirlenebilir. Bu sistemlerin veri kaynakları, sağlayıcıları, kullanıcıları ve temel veri akışları incelenebilir.
Aynı dönemde kişisel veri işleme faaliyetleri ve olası yurt dışı veri aktarımları açısından mevcut durum değerlendirilebilir.
İkinci 30 günde öncelikli risk alanları belirlenebilir. Yüksek etkili kullanım senaryoları, hassas veri işleme faaliyetleri, kritik tedarikçi bağımlılıkları ve belirsiz sorumluluk alanları üzerinde çalışılabilir.
Bu aşamada uygulanabilir hukuki yükümlülüklerin uzmanlar tarafından değerlendirilmesi, gerekli sözleşmesel ve teknik kontrollerin belirlenmesi önemlidir.
Son 30 günde ise seçilen kullanım senaryolarında kontrol mekanizmaları test edilebilir.
Örneğin yeni bir AI ajanının veri erişim yetkilerinin nasıl onaylanacağı, bir model değişikliğinin hangi değerlendirmeleri tetikleyeceği veya veri işleme ihlali şüphesinin hangi süreçle ele alınacağı uygulamalı olarak doğrulanabilir.
Benim açımdan ilk 90 günün temel çıktısı, bütün düzenleyici yükümlülüklerin tamamlandığını iddia eden bir uyum sertifikası değildir.
Şirketin hangi yapay zekâ sistemlerini kullandığını, hangi verilerin işlendiğini, hangi risklerin öncelikli olduğunu ve bu risklerin kimler tarafından nasıl yönetileceğini gösteren işleyen bir yönetişim yapısıdır.
Uyumun Ekonomik Boyutu: Maliyet mi, Rekabet Yeteneği mi?
Veri koruma ve yapay zekâ düzenlemelerine uyumun belirli maliyetler oluşturduğu açıktır.
Hukuki değerlendirmeler, teknik güvenlik kontrolleri, veri mimarisi iyileştirmeleri, tedarikçi yönetimi, çalışan eğitimleri ve denetim faaliyetleri kaynak gerektirir.
Ancak bu maliyetleri yalnızca zorunlu harcamalar olarak değerlendirmeyi eksik buluyorum.
Doğru tasarlanmış veri yönetişimi ve yapay zekâ kontrol mekanizmaları, bazı koşullarda operasyonel belirsizliği azaltabilir, tedarikçi risklerini görünür hâle getirebilir ve yeni pazarlara giriş süreçlerini destekleyebilir.
Özellikle kurumsal müşterilere yapay zekâ tabanlı hizmet sunan şirketler açısından güvenlik, veri koruma ve denetlenebilirlik yetkinlikleri ticari değerlendirmelerin önemli bir parçası olabilir.
Ancak uyum yatırımlarının her zaman doğrudan gelir artışı sağlayacağını varsaymak doğru değildir.
Bu yatırımların ekonomik etkisi sektör, müşteri beklentileri, risk profili ve mevcut kurumsal olgunluk gibi faktörlere bağlıdır.
Benim yaklaşımımda uyum programının ekonomik değerlendirmesi yapılırken yalnızca uygulama maliyetleri değil, azaltılması hedeflenen riskler, desteklenen iş fırsatları ve operasyonel sürdürülebilirlik de dikkate alınmalıdır.
Burada önemli olan, düzenlemelere uyumu bir pazarlama iddiasına dönüştürmek değildir.
Gerçek kontrollerle desteklenen, gerektiğinde kanıtlanabilen bir kurumsal güvenilirlik kapasitesi oluşturmaktır.
Geleceğin İşletme Modelinde Veri Egemenliği Kimin Sorumluluğunda Olacak?
Veri egemenliğinin yalnızca bilgi teknolojileri yöneticisinin veya kişisel veri koruma ekibinin sorumluluğunda kalamayacağını düşünüyorum.
Çünkü veri, artık yalnızca operasyonel sistemlerde saklanan bir kaynak değil; analitik modellerin, yapay zekâ ajanlarının ve stratejik karar süreçlerinin temel girdilerinden biri.
Bu nedenle veri egemenliği, şirketin üst yönetim gündeminde yer almalıdır.
Ancak üst yönetimin her teknik veri işleme kararını doğrudan vermesi gerektiğini savunmuyorum.
Stratejik düzeyde veri ve yapay zekâ kullanımına ilişkin risk iştahı, temel ilkeler ve sorumluluklar belirlenmelidir.
Operasyonel düzeyde ise veri sahipleri, teknoloji ekipleri, bilgi güvenliği, hukuk ve ilgili iş birimleri kendi yetki alanlarında çalışmalıdır.
Benim açımdan doğru yönetişim modeli, merkezi standartlarla dağıtık sorumlulukları birleştiren yapıdır.
Şirketin bütün birimleri için ortak veri koruma ve yapay zekâ ilkeleri bulunabilir. Ancak her kullanım senaryosunun iş sonuçları ve operasyonel riskleri ilgili süreç sahibi tarafından yönetilmelidir.
Bu yaklaşım, yapay zekâ yatırımlarının ölçeklenmesi açısından da önemlidir.
Çünkü şirket büyüdükçe bütün kararların merkezi bir komiteden geçmesi operasyonel darboğaz oluşturabilir.
Buna karşılık standartların bulunmadığı tamamen dağıtık bir yapı da tutarsız veri işleme uygulamalarına ve kontrol boşluklarına neden olabilir.
Bana göre geleceğin işletme modelinde önemli olan, bu iki uç arasında riskle orantılı bir yönetişim dengesi kurabilmektir.
Sonuç: Veri Üzerinde Kontrol Olmadan Yapay Zekâ Üzerinde Gerçek Kontrol Kurulabilir mi?
Yapay zekâ çağında kurumsal dönüşümün yalnızca yeni modellerin, otomasyonların ve dijital ajanların devreye alınmasından ibaret olmadığını düşünüyorum.
Bu teknolojilerin hangi verilerle çalıştığı, hangi kararları etkilediği, hangi sağlayıcılara bağımlı olduğu ve hangi hukuki sınırlar içerisinde kullanıldığı, geleceğin işletme modelinin önemli bileşenleridir.
KVKK ve AB Yapay Zekâ Yasası bu açıdan yalnızca uyulması gereken düzenlemeler olarak görülmemelidir.
Şirketlerin veri yönetimi, yapay zekâ yönetişimi ve operasyonel sorumluluklarını daha sistematik biçimde değerlendirmelerine de neden olmaktadır.
Ancak düzenleyici uyum ile kurumsal güvenilirliğin aynı şey olmadığını özellikle vurgulamak istiyorum.
Bir şirket belirli mevzuat yükümlülüklerini yerine getirmiş olabilir. Buna rağmen zayıf veri kalitesi, yetersiz erişim kontrolü veya kötü tasarlanmış operasyonel süreçler nedeniyle önemli riskler taşımaya devam edebilir.
Benzer şekilde güçlü teknik güvenlik kontrollerinin bulunması da hukuki yükümlülüklerin kendiliğinden karşılandığı anlamına gelmez.
Bu nedenle veri egemenliği, güvenlik, kişisel veri koruma ve yapay zekâ yönetişiminin birbirini tamamlayan ancak farklı uzmanlık ve kontrol gereksinimleri bulunan alanlar olarak yönetilmesi gerektiğine inanıyorum.
Geleceğin işletmelerinde önemli rekabet avantajlarından birinin, yalnızca yapay zekâyı kullanabilmek değil, bu teknolojiyi güvenilir, denetlenebilir ve sürdürülebilir biçimde kurumsal faaliyetlere entegre edebilmek olacağını düşünüyorum.
Bu nedenle yöneticilerin kendilerine sorması gereken soru yalnızca hangi yapay zekâ modellerini kullanacakları değildir.
Asıl soru şu: Şirketimiz, yapay zekânın kullandığı veriler, gerçekleştirdiği işlemler ve etkilediği kararlar üzerinde gerçekten yeterli kontrol sahibi mi?
Benim için veri egemenliği ve yapay zekâ uyumunun stratejik anlamı burada ortaya çıkıyor.
Çünkü geleceğin işletme modelini tasarlarken teknolojiye erişim kadar, teknolojinin hangi sınırlar içerisinde ve kimin sorumluluğunda çalışacağını belirleyebilmek de önem taşıyor.
Yapay zekâ kapasitesi şirketin neler yapabileceğini belirler. Veri egemenliği ve yönetişim ise bunları ne kadar güvenilir ve sürdürülebilir biçimde yapabileceğinin sınırlarını çizer.
Bilgin Çavuş
Kurumsal Dönüşüm Stratejisti
Astrum Consulting Group — Kurucu ve Yönetici Ortak
bilgincavus.com
Editoryal ve hukuki not: Bu makale kurumsal dönüşüm ve yapay zekâ yönetişimi perspektifinden hazırlanmış genel bir değerlendirmedir; hukuki görüş veya somut bir şirket için uyum değerlendirmesi değildir. Özellikle AB Yapay Zekâ Yasası'nın uygulama tarihleri, kapsamı ve geçiş hükümleri yayımlanma tarihinde güncel resmî kaynaklardan doğrulanmalıdır.